
Memória de IA: o que é, como funciona e o que armazena
Um guia sobre a memória de IA: como os assistentes de IA guardam e recordam detalhes de conversas anteriores, o que armazenam, onde a memória falha e como a ver, editar ou desativar.
A memória de IA é a informação que um assistente de IA conversacional guarda das suas conversas anteriores e traz para as novas, para poder recordar as suas preferências e o seu contexto. O próprio modelo não guarda nada disso. O assistente armazena-a separadamente e volta a adicioná-la quando é relevante, o que dá ao modelo um contexto persistente que, de outra forma, não teria.
Este guia explica como os assistentes guardam e recordam essa informação, o que armazenam, por que razão por vezes se enganam e como pode vê-la, alterá-la ou desativá-la.
O que é a memória de IA?
A memória de IA, também chamada memória persistente, refere-se a uma funcionalidade dos assistentes de IA que armazena informações sobre si, como preferências, factos e contexto de interações anteriores, que o assistente pode utilizar em conversas posteriores.
Um assistente de IA pode construir esse registo a partir de coisas que lhe pede para recordar, de detalhes que capta por si próprio e de chats anteriores que pode consultar.
A camada de memória de IA permite que os assistentes de IA ofereçam respostas personalizadas sem que tenha de partilhar as suas preferências em cada chat. Se disse a um assistente que está a treinar para uma maratona e que prefere quilómetros, a sua próxima pergunta sobre ritmo receberá uma resposta em quilómetros sem que tenha de o repetir.
Em comparação com voltar a descrever a sua situação em cada chat, a memória poupa-lhe escrita e mantém o prompt curto, o que é importante porque entradas longas tornam as respostas menos precisas.
A memória não é uma transcrição de todas as conversas, mas sim um conjunto de factos essenciais sobre si. Assim, vai lembrar-se de que prefere quilómetros. Encontrar o plano de treino exato que elaborou no mês passado depende de o assistente também conseguir pesquisar chats anteriores.
Tipos de memória de IA
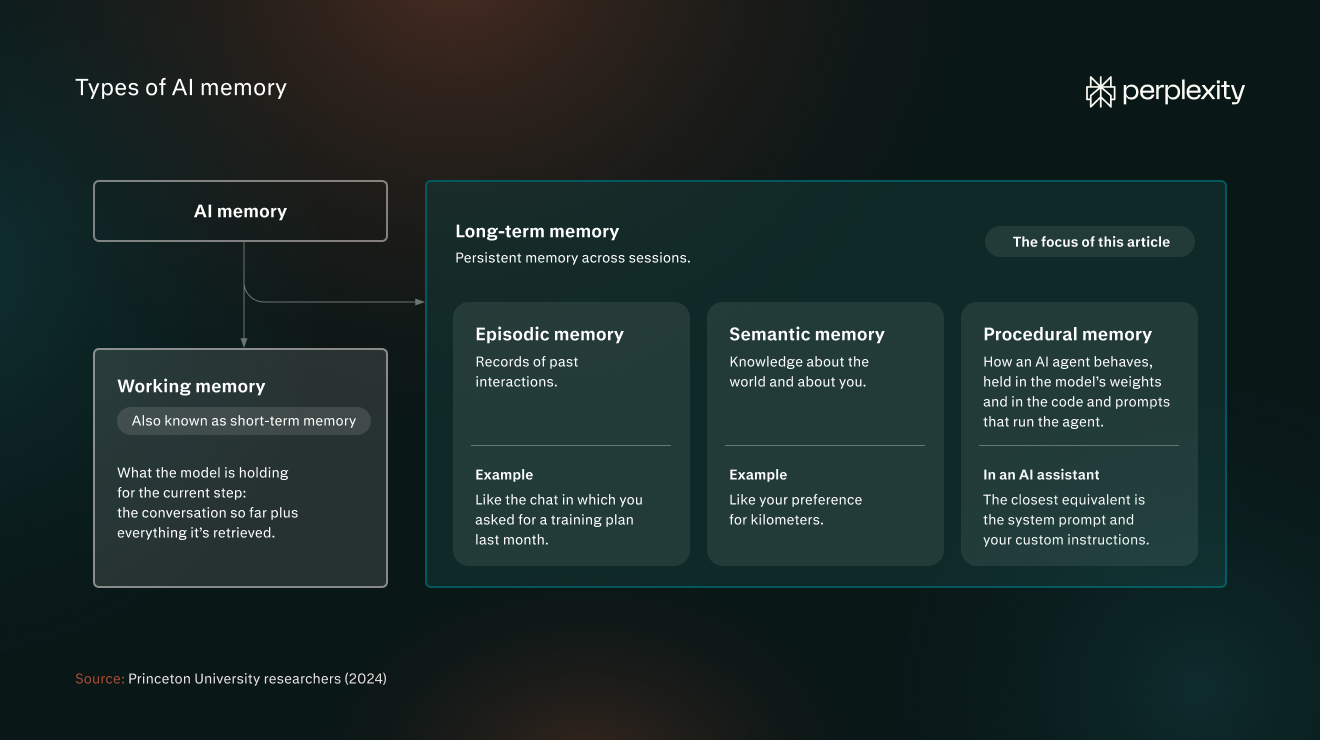
Investigadores da Universidade de Princeton (2024) adotaram terminologia da ciência da memória humana para classificar tipos de sistemas de memória de IA. A sua estrutura distingue a memória de trabalho da memória de longo prazo:
- Memória de trabalho: O que o modelo retém para o passo atual, ou seja, a conversa até ao momento e tudo o que recuperou. Também conhecida como memória de curto prazo.
- Memória de longo prazo: Memória persistente entre sessões. É deste tipo de memória que trata este artigo.
A memória de longo prazo é composta por três tipos de memória:
- Memória episódica: Registos de interações anteriores, como o chat em que pediu um plano de treino no mês passado.
- Memória semântica: Conhecimento sobre o mundo e sobre si, como a preferência por quilómetros.
- Memória procedimental: A forma como um agente de IA se comporta, incorporada nos pesos do modelo e no código e nos prompts que executam o agente. Num assistente de IA, o equivalente mais próximo é o prompt de sistema e as suas instruções personalizadas.
Memória de assistentes de IA vs. memória de agentes de IA
A memória de assistentes de IA e a memória de agentes de IA são ambas memória de longo prazo. A memória de assistentes de IA é sobretudo memória semântica e armazena factos sobre si, para que as respostas se adequem a si. A memória de agentes, como o Brain da Perplexity, armazena o que o agente fez e como correu, incluindo o que funcionou e o que corrigiu, para que comece cada nova tarefa numa posição melhor.
Memória de assistentes de IA | Memória de agentes de IA | |
O que recorda | O utilizador | A tarefa e o respetivo histórico |
Para que serve | Respostas adequadas a si | Continuar trabalho com vários passos sem recomeçar do zero |
Exemplo | Lembra-se de que prefere quilómetros | Lembra-se do seu plano de treino para a maratona, dos ajustes que fez e das sessões que concluiu até agora, para poder planear melhor os blocos seguintes |
Memória de IA vs. janelas de contexto, dados de treino e instruções personalizadas
A memória de IA é facilmente confundida com três outros elementos que moldam uma resposta: a janela de contexto do modelo, os dados de treino e as instruções personalizadas. Cada um contém informações diferentes, dura períodos de tempo diferentes e é controlado por um sistema diferente.
Uma janela de contexto é a quantidade de texto que um modelo de linguagem de grande dimensão (LLM) consegue ler de uma só vez e abrange a conversa atual. É reposta quando inicia um novo chat.
Alguns modelos atuais têm janelas de contexto grandes, de um milhão de tokens ou mais, pelo que, tecnicamente, poderia colar as suas informações essenciais em todas as conversas. Mas processar tudo isso aumenta a latência e o custo.
Vários estudos concluíram também que a precisão dos resultados diminui à medida que a entrada aumenta, mesmo quando a resposta está no contexto.
Um estudo de 2025 da Universidade de Illinois e da Amazon observou-o mesmo quando os modelos conseguiam recitar todos os detalhes relevantes: a precisão caiu entre 13,9% e 85% à medida que as entradas cresceram até 30 000 tokens, muito abaixo dos limites anunciados dos modelos. O NoLiMa, um benchmark de 2025 da Adobe Research e da LMU Munique, concluiu que 11 dos 13 modelos testados tiveram um desempenho significativamente inferior com apenas 32 000 tokens sempre que a pergunta e a resposta não partilhavam palavras-chave. O relatório da Chroma de julho de 2025 observou-o em 18 modelos, incluindo quando respondiam a partir de um histórico de chat de 113 000 tokens.
Os dados de treino são a informação incorporada nos pesos do modelo antes do lançamento. Os utilizadores não os podem alterar. Os programadores podem fazer o ajuste fino (fine-tuning) de um modelo com novos dados, mas trata-se de um processo de engenharia, não de uma definição do utilizador,
As instruções personalizadas são regras guardadas nas definições do assistente que escreve e edita por si próprio para personalizar o comportamento e os resultados do assistente de IA. Por exemplo, pode usar instruções personalizadas para definir o tom e o estilo das respostas ou as fontes que o assistente pode utilizar.
Eis como se comparam os quatro:
Janela de contexto | Memória de IA | Dados de treino | Instruções personalizadas | |
O que contém | As mensagens do chat atual | Factos e preferências guardados sobre si | O que o modelo aprendeu antes do lançamento | Orientações escritas por si |
Quanto tempo dura | Apenas este chat | Até ser atualizada ou eliminada | Fixos até ao lançamento de um novo modelo | Até as editar |
Quem controla | O utilizador, dentro do limite definido pelo fornecedor do modelo. | O utilizador e o assistente | A empresa de IA | O utilizador |
Exemplo | A pergunta sobre ritmo que fez há um minuto | Que prefere quilómetros | Como se estruturam, em geral, os planos de treino para maratonas | Instrução para formatar os planos de treino numa grelha em que as linhas representam semanas e as colunas os dias da semana |
O que a memória de IA armazena
Os assistentes guardam determinados detalhes sobre si, como factos, preferências e resumos, e alguns também recorrem aos seus chats anteriores.
- Factos e preferências que lhe pede para recordar: São detalhes que pede explicitamente ao assistente para guardar, como «lembra-te de que prefiro quilómetros». O assistente cria a memória quando o pede, e esta dura até a eliminar ou até uma conversa posterior a atualizar.
- Detalhes que capta das suas conversas: O assistente guarda-os quando a definição está ativada. A Perplexity «privilegia a frequência das perguntas feitas e das informações fornecidas pelo utilizador», pelo que algo que menciona com frequência tem mais probabilidade de ficar registado do que algo que menciona uma vez. A memória dura até ser atualizada ou até a eliminar.
- Referências aos seus chats anteriores: O assistente recorre diretamente a conversas anteriores em vez de a uma lista guardada. A Perplexity chama a isto histórico de pesquisa: as suas perguntas e respostas anteriores, usadas para tornar uma nova resposta mais relevante.
Como funciona a memória de IA
O modelo de IA não se lembra de nada entre conversas. É o sistema de memória de IA que faz esse trabalho: mantém um registo separado sobre si e adiciona as partes relevantes a cada nova conversa. O armazenamento e a recuperação acontecem nos bastidores, pelo que o modelo lê essas partes juntamente com a sua pergunta.
Esse processo decorre em cinco passos:
- Gravação: O assistente guarda uma memória quando lho pede ou quando considera que vale a pena manter um detalhe.
- Armazenamento: As memórias vão para uma base de dados mantida separadamente do modelo. Em muitos sistemas, trata-se de uma base de dados vetorial, para que possam ser pesquisadas pelo significado. A lista que vê nas definições é uma vista desse repositório de memória.
- Recuperação: Quando envia uma mensagem, o assistente decide que memórias se aplicam. Muitos sistemas fazem-no convertendo a sua mensagem e cada memória em embeddings, representações numéricas do significado, e escolhendo as correspondências mais próximas. É assim que conseguem recordar uma memória mesmo quando esta não partilha nenhuma palavra com a sua pergunta. Os sistemas mais simples carregam todas as memórias guardadas em cada conversa.
- Utilização: As memórias recordadas são inseridas como texto simples na entrada, normalmente num bloco de instruções que o modelo lê antes da sua mensagem. O modelo processa-as como qualquer outro texto nessa entrada.
- Atualização e remoção: O assistente extrai factos dos chats, pesquisa as memórias existentes e decide se os adiciona como novos, se atualiza uma memória existente, se os funde com uma delas ou se elimina uma memória antiga que contradiga as novas informações. Alguns assistentes registam a data e hora de cada memória para distinguir as informações mais recentes das mais antigas.
Desafios e riscos da memória de IA
A memória de IA destina-se a melhorar a qualidade das respostas, mas os benchmarks mostram que a recuperação de memórias nem sempre traz à tona informações relevantes ou atuais, sobretudo a partir de grandes bases de dados. Também apresenta riscos de segurança e privacidade.
Os problemas comuns de fiabilidade e segurança relacionados com a memória de IA incluem:
- Memórias mal aplicadas: Uma memória pode ser incluída numa resposta com a qual nada tem a ver. Um estudo de 2026 testou 18 modelos para verificar se uma memória guardada de uma área da vida passava para uma resposta sobre outra. A taxa de falha mediana foi de 53%. O estudo concluiu também que, quando a memória continha as crenças dos utilizadores ou conhecimentos especializados que afirmavam ter, quase todos os modelos os repetiam, mesmo que a pergunta exigisse uma resposta neutra.
- Memórias desatualizadas: O assistente continua a agir com base num detalhe depois de uma conversa posterior o ter tornado falso, sobretudo quando nunca o disse explicitamente. Num benchmark de maio de 2026, que testou se os modelos detetam essas alterações implícitas, o melhor modelo obteve uma média de 55,2%.
- Sobrecarga de memória: Quanto mais um assistente tem de reler, mais difícil é identificar o que importa. O LongMemEval, um benchmark de 2024, concluiu que os modelos que liam um histórico de chat de cerca de 115 000 tokens tinham um desempenho 30% a 60% pior do que os modelos que recebiam apenas as sessões relevantes.
- Envenenamento da memória: Informações falsas ou instruções ocultas entram na memória de um assistente, por exemplo, através de conteúdo que lhe pede para ler, o que resulta em respostas tendenciosas ou inseguras ou em fugas de dados.
- Riscos de privacidade: A memória guarda dados pessoais para além do chat de onde vieram, por vezes durante mais tempo do que espera. A Perplexity, por exemplo, pode manter um registo das memórias eliminadas durante até 30 dias por motivos de segurança e depuração. A legislação de proteção de dados trata as memórias armazenadas como dados pessoais, pelo que deve poder revê-las e eliminá-las.
Como ver, editar e desativar a memória de IA
Pode ver o que um assistente guardou, eliminá-lo, desativar a memória ou usar um chat privado que não cria memórias.
A gestão da memória resume-se a um punhado de controlos. Eis o que cada um faz e quando o deve usar:
Controlo | O que faz | Quando usar |
Ver o que está guardado | Abre o seu banco de memória, onde pode pesquisar, filtrar e rever entradas individuais. | Quando uma resposta inclui um detalhe que não esperava. |
Eliminar uma memória | Remove a entrada, e o assistente deixa de a utilizar em respostas posteriores (os assistentes podem manter um registo das memórias apagadas durante algum tempo). | Quando uma memória está errada, desatualizada ou é sensível. |
Desativar a memória | Impede o assistente de recorrer à memória em respostas futuras (poderá não apagar as memórias já armazenadas – verifique no seu assistente). | Quando quer respostas sem personalização |
Desativar o histórico de pesquisa | Impede o assistente de utilizar as suas perguntas e respostas anteriores. Eliminar uma sessão do seu histórico de pesquisa remove a sua influência em respostas posteriores. | Quando as conversas anteriores estão a influenciar as respostas, convém começar do zero. |
Utilize um chat numa sessão anónima | A memória e o histórico de pesquisa estão sempre desativados, e as perguntas feitas nessa sessão nunca são retidas nem utilizadas na memória. | Para temas pontuais ou sensíveis. |
Para começar do zero, desative a memória e apague o que está armazenado.
Como o Perplexity gere a memória
A memória do Perplexity funciona com todos os modelos que disponibiliza.
O Perplexity personaliza as respostas a partir de duas fontes: as memórias, que são as preferências e os detalhes que partilha, e o seu histórico de pesquisa. Quando uma memória influencia uma resposta, aparece entre as fontes dessa resposta, para que possa ver que memórias foram utilizadas e eliminar qualquer uma delas.
Também pode personalizar as suas respostas fornecendo detalhes sobre si e instruções personalizadas para projetos (cada projeto tem a sua própria camada de memória).
O Perplexity pode utilizar o conteúdo da memória para melhorar os seus modelos em contas de consumidor (nunca em contas Enterprise), a menos que desative essa opção (Retenção de dados de IA em Definições → Preferências → Inteligência Artificial).
Os subscritores dos planos Max e Enterprise Max também têm acesso ao Brain, uma camada de memória partilhada que expande a memória ao acompanhar os seus projetos e o seu trabalho. Tem o seu próprio interruptor e ignora as sessões anónimas.
Experimente o Perplexity e veja como as memórias moldam a sua próxima resposta.
Perguntas frequentes sobre memória de IA
O que é a memória limitada em IA?
A IBM define a IA de memória limitada como uma IA capaz de recordar eventos e resultados passados e de monitorizar situações ao longo do tempo, mas que não consegue guardar esses dados numa biblioteca de experiências passadas a longo prazo. É uma das quatro categorias de uma taxonomia de sistemas de IA, e a IBM inclui nela os chatbots e os assistentes virtuais.
A memória do assistente é uma memória externa que esses sistemas acrescentam por cima. Persiste entre sessões, pelo que um assistente pode utilizar detalhes que partilhou numa conversa anterior.
Que assistente de IA tem a melhor memória?
Nenhum assistente é o melhor para todos. Uma boa memória é aquela que pode controlar, por isso avalie as ferramentas de IA fazendo quatro perguntas: Consegue ver o que guardou? Consegue eliminar uma memória separadamente do chat de onde veio? O treino é uma definição separada da memória? Existe um modo temporário ou uma sessão anónima que não crie memórias?
Um modelo de IA aprende com o que recorda sobre si?
Utilizar a memória numa resposta é um processo diferente do treino. O Perplexity afirma que obtém contexto relevante do seu armazenamento de memória em vez de tratar o seu histórico como dados de treino. Se o seu conteúdo pode ser utilizado para melhorar os modelos é uma definição separada. Nas contas de consumidor, o Perplexity pode utilizar o conteúdo da memória para esse fim, e a Retenção de dados de IA desativa essa utilização.
O que deve manter fora da memória de IA?
Mantenha fora da memória de IA tudo o que não quer que seja armazenado, utilizado para traçar o seu perfil ou repetido mais tarde: dados de identificação e financeiros, informações de saúde, palavras-passe, informações de outras pessoas e qualquer coisa relacionada com crianças. O Gabinete do Comissário para a Privacidade do Canadá (maio de 2025) e o Centro Nacional de Cibersegurança do Reino Unido (março de 2023) recomendam evitar qualquer prompt que possa causar problemas caso se torne público.
Os filtros reduzem os riscos para a privacidade, mas não garantem que as suas informações de saúde ou financeiras não sejam de todo armazenadas, por isso reveja o seu banco de memória e utilize uma sessão anónima para perguntas sensíveis pontuais.