
Como acompanhar e controlar o gasto de tokens da equipa
Como as equipas podem ver a utilização de tokens em painéis e relatórios, que tipos de trabalho de IA usam mais tokens e como usar controlos para a reduzir.
O que é o gasto de tokens
O gasto de tokens é o número de tokens que uma equipa consome com IA e o custo desses tokens. Um token é uma unidade de texto, como uma palavra, parte de uma palavra ou um sinal de pontuação, que um modelo de IA lê ou escreve. Em inglês, 1 token corresponde aproximadamente a 4 caracteres. Os tokens não estão padronizados entre modelos ou fornecedores, pelo que o mesmo texto pode produzir uma contagem diferente em ferramentas diferentes.
Os relatórios de utilização costumam dividir os tokens em alguns tipos:
- Os tokens de entrada são tudo o que o modelo lê num pedido. Isto inclui a consulta, qualquer texto anexado e o histórico de conversa anterior do mesmo tópico que o modelo reutiliza.
- Os tokens de saída são a resposta que o modelo escreve. Costumam custar mais do que os tokens de entrada. Nos preços da API da Perplexity, alguns modelos cobram seis vezes mais pela saída.
- Os tokens de raciocínio são texto que um modelo gera internamente para resolver um problema antes de responder. Não aparecem na resposta, pelo que uma resposta visível mais longa não significa necessariamente que um modelo tenha usado mais tokens no total.
As equipas que usam ferramentas de IA por subscrição raramente veem uma cobrança por token. Ainda assim, os tokens determinam o que obtêm, já que as tarefas mais pesadas gastam créditos ou atingem os limites de utilização mais depressa. Já as equipas que criam as suas próprias ferramentas sobre um modelo de IA pagam normalmente por token, num modelo de preços baseados na utilização.
Como acompanhar o gasto de tokens
Acompanhar o gasto de tokens num plano de subscrição
As ferramentas por subscrição normalmente não mostram a contagem de tokens. Em vez disso, muitos planos usam créditos, unidades pré-pagas que o plano vai descontando à medida que o trabalho é feito. Os créditos não são o mesmo que tokens, já que um crédito pode cobrir texto, imagens ou outro trabalho. Mas as tarefas que usam mais tokens costumam também usar mais créditos, por isso são o melhor indicador do gasto de tokens numa subscrição. Os utilizadores podem acompanhar a sua própria utilização de créditos, e alguns planos incluem também um painel de administração que mostra a utilização de créditos de toda a equipa.
Na Perplexity, por exemplo, as pesquisas normais não usam créditos. Só o Perplexity Computer, o assistente que trata de tarefas com vários passos, os usa. Quem usa o Computer pode ver quantos créditos já usou e em quê. Cada tarefa do Computer mostra também o seu próprio total de créditos no menu "Utilização" da respetiva conversa.
Nos planos Enterprise, os administradores podem ver quantas pessoas usam a Perplexity e quantas consultas fazem por semana no painel Insights (disponível para organizações com 50 ou mais postos, ou com pelo menos um membro Enterprise Max).
Acompanhar o gasto de tokens nos relatórios de utilização da API
Os relatórios de utilização do fornecedor da API mostram diretamente a contagem de tokens, normalmente dividida por tipo de token. A consola da API Platform da Perplexity, por exemplo, permite aos utilizadores acompanhar métricas como o gasto de tokens de entrada, de saída e de raciocínio na página Faturação.
Porque é que o gasto de tokens está a aumentar
Os agentes executam muitos passos por tarefa, e cada passo é um pedido separado a um modelo. Uma única tarefa pode chegar a centenas de milhares ou até milhões de tokens.
Os modelos de raciocínio também estão a tornar-se mais comuns. Um modelo de raciocínio escreve o seu raciocínio antes de responder, e cada palavra desse texto conta como tokens. Por isso, o mesmo pedido costuma usar mais tokens num modelo de raciocínio do que num modelo padrão, mesmo que a resposta no ecrã pareça ter o mesmo tamanho.
Por fim, à medida que mais pessoas e fluxos de trabalho usam IA em geral, a utilização de tokens vai-se acumulando. Parte desse crescimento vem também do tokenmaxxing, em que os engenheiros executam agentes sobretudo para aumentar a sua contagem pessoal de tokens e subir nas classificações internas de tokens.
Como reduzir o gasto de tokens
A maior parte do gasto elevado de tokens vem de alguns tipos de trabalho que usam mais tokens do que parece.
Conversas longas e tarefas de agentes
Sempre que um modelo responde, normalmente volta a ler toda a conversa até esse momento. Cada novo pedido inclui todo o histórico anterior da conversa, mais a mensagem atual do utilizador. Por isso, uma pergunta curta feita no final de um tópico longo usa mais tokens do que a mesma pergunta num tópico novo. As tarefas de agentes funcionam da mesma forma, porque cada passo acrescenta os seus resultados ao histórico que o passo seguinte volta a ler.
O que fazer
- Inicie uma nova conversa quando o tema mudar. Comece-a com um resumo de duas ou três linhas de tudo o que o modelo ainda precisa de saber do tópico anterior.
- Divida as tarefas longas de agentes em tarefas mais pequenas. Execute cada parte como uma tarefa própria e passe apenas os resultados de que a parte seguinte precisa.
- Verifique se as ferramentas de agentes da equipa usam compactação de contexto. A compactação resume automaticamente as partes mais antigas de uma tarefa, para que o modelo tenha menos para reler. Se uma ferramenta a disponibilizar como definição, ative-a.
Os mesmos documentos processados vezes sem conta
Quando alguém anexa o mesmo ficheiro longo, como um manual de políticas ou um catálogo de produtos, a muitas consultas separadas, o modelo lê o ficheiro inteiro de cada vez. Cada leitura conta como tokens de entrada.
O que fazer
- Ensine os utilizadores a copiar a secção relevante de um manual ou catálogo para o pedido, em vez de anexarem o ficheiro inteiro.
- Crie uma versão resumida dos documentos que a equipa usa com frequência. Um resumo de uma página de uma política extensa pode substituir o documento completo nas consultas de rotina.
Novas tentativas e ciclos
Quando uma resposta não é aquilo de que alguém precisava e essa pessoa volta a executar a tarefa, cada tentativa usa tokens. O mesmo acontece quando um agente fica preso a repetir o mesmo passo.
O que fazer
- Especifique a tarefa, o resultado e as fontes logo no primeiro pedido. Por exemplo: "Resume os principais motivos pelos quais os clientes cancelaram no 3.º trimestre, usando apenas os resultados do inquérito em anexo, em cinco pontos."
- Verifique os primeiros passos de uma tarefa de agente. Se o agente repetir o mesmo passo ou a mesma pesquisa, pare-o e recomece com um pedido mais específico.
Modelos grandes em tarefas simples
Os modelos mais capazes costumam custar mais por token, pelo que o trabalho de rotina, como resumos ou reformatação, pode esgotar o orçamento de uma equipa mais depressa do que o necessário.
O que fazer
- Use o encaminhamento de modelos, que atribui cada tarefa a um modelo capaz de a realizar. Uma reescrita curta ou um resumo pode ir para um modelo mais pequeno e barato, e o modelo mais capaz fica reservado para raciocínio ou análise com vários passos. A API da Perplexity segue esta abordagem com as suas predefinições, que atribuem um modelo mais pequeno a uma consulta rápida e um maior a uma análise exaustiva.
Picos após novos fluxos de trabalho
Um novo fluxo de trabalho automatizado, ou uma ferramenta implementada numa equipa inteira, pode fazer disparar a utilização de um dia para o outro. Um pico não é um problema em si, mas vale a pena saber que trabalho o causou.
O que fazer
- Teste primeiro os novos fluxos de trabalho com um grupo pequeno. Analise a utilização desse grupo durante uma ou duas semanas antes de implementar o fluxo de trabalho em toda a equipa.
- Defina um orçamento mensal para cada equipa. Baseie-o na utilização de um mês típico, para que um aumento se destaque.
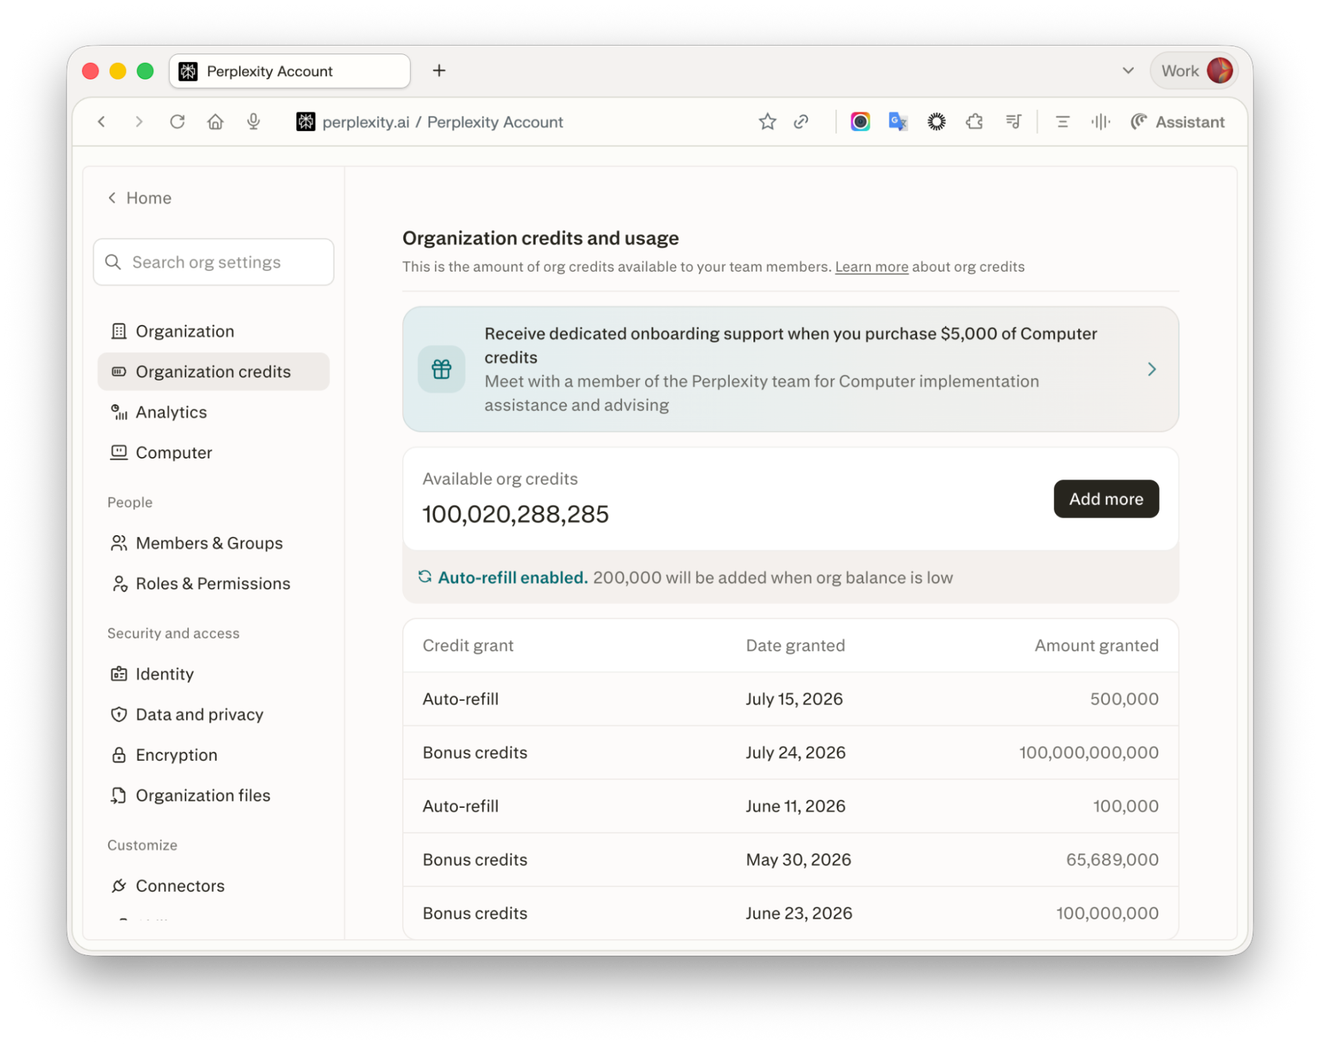
- Desative a recarga automática. Com a recarga automática desativada, o trabalho para quando os créditos se esgotam, em vez de serem comprados mais créditos automaticamente.
Como otimizar o gasto de tokens na Perplexity
Para utilização diária
O Computer usa créditos, mas só é executado quando o escolhe, seja ao selecionar o ícone do Computer, ao trabalhar num Projeto cujo modo predefinido é o Computer, ou ao usar o modo Work do Comet.
Para voltar à pesquisa normal, selecione o ícone da Perplexity para regressar ao modo Ask. Para ver a utilização de créditos, os utilizadores podem abrir o monitor de créditos na interface da Perplexity.
As equipas que trabalham em Projetos, os espaços de trabalho partilhados da Perplexity, podem definir o modo predefinido de cada Projeto como Search ou Computer. Um Projeto usado sobretudo para pesquisas rápidas pode ter o Search como predefinição, para que ninguém inicie uma tarefa do Computer por engano.
Para administradores Enterprise
- Saiba o que inclui cada posto. Os utilizadores Enterprise Pro recebem uma atribuição mensal de 500 créditos, e os utilizadores Enterprise Max recebem 15 000 créditos. Estes créditos expiram no final de cada ciclo mensal e não transitam para o ciclo seguinte.
- Comece por definir um limite de utilização predefinido. Um limite de utilização restringe quantos créditos extra um membro pode retirar da reserva partilhada depois de esgotar a sua própria atribuição.
- Crie limites com nome para diferentes tipos de utilizadores. Os administradores podem configurar limites como "Padrão", "Utilizador avançado" e "Prestador de serviços" e atribuí-los a grupos de utilizadores ou a membros individuais. Os grupos podem ser criados na Perplexity ou sincronizados a partir do fornecedor de identidade da empresa. Se alguém pertencer a mais do que um grupo, aplica-se o limite mais elevado.
- Use substituições pessoais para exceções. Quando uma pessoa precisa de um limite diferente do que se aplica ao seu grupo, uma substituição pessoal tem prioridade sobre qualquer limite de grupo ou partilhado. Isto é útil para um projeto curto com muita pesquisa, sem aumentar o limite de toda a equipa.
- Defina um teto para a recarga automática. A recarga automática repõe automaticamente a reserva partilhada. Inclui um limite mensal de recarga configurável, para que os gastos não possam crescer sem um máximo definido.
- Decida como os membros podem pedir mais créditos. A definição "Permitir que os membros solicitem mais créditos" deixa que quem atinja o seu limite peça mais créditos a um administrador, em vez de ficar simplesmente bloqueado.
- Reveja a utilização todos os meses. A página Créditos da organização mostra os créditos atribuídos, usados e restantes de cada membro, juntamente com os limites de grupo e o saldo da reserva. Para organizações com 50 ou mais postos, ou com pelo menos um membro Enterprise Max, o painel Insights acrescenta os utilizadores ativos mensais e as consultas semanais ao longo do tempo. Para mais detalhes, os registos de auditoria guardam a execução de tarefas, a utilização de conectores, o consumo de créditos e as atribuições de créditos.
Para equipas que desenvolvem com a API
- Atribua a cada ferramenta ou equipa a sua própria chave de API. A Perplexity pode mostrar a faturação de cada chave separadamente, e chaves separadas deixam claro que ferramenta está a impulsionar a utilização.
- Consulte a página de faturação para ver que tipo de token está a aumentar. A página mostra os tokens de entrada, de saída e de raciocínio ao longo do tempo. Um aumento dos tokens de entrada significa normalmente que uma ferramenta está a enviar mais texto do que o necessário. Um aumento dos tokens de raciocínio significa que há tarefas a ser executadas em modelos que analisam os problemas de forma prolongada.
- Use a Search API quando uma ferramenta só precisa de resultados de pesquisa. Devolve resultados da web sem que um modelo escreva uma resposta e cobra por pedido, sem custos adicionais baseados em tokens.
- Comece as ferramentas de agentes a partir de uma predefinição. As predefinições da Perplexity ajustam o tamanho do modelo ao tamanho da tarefa e mantêm os pedidos simples afastados dos modelos mais caros.
Trabalho prioritariamente local
Alguns trabalhos nem sequer precisam de um modelo pago na nuvem. O Portable Computer é uma versão do agente da Perplexity que é executada no próprio computador da pessoa, usando um modelo de IA guardado nessa máquina. Como o modelo é executado localmente, o trabalho de rotina não usa tokens pagos. Só recorre à web, a aplicações ligadas ou a um modelo na nuvem mais potente quando uma tarefa o exige, e pede primeiro autorização ao utilizador.
Descubra como o Perplexity Computer trata de trabalho com vários passos na web, em ficheiros e em ferramentas ligadas.
Perguntas frequentes
Qual é a diferença entre o gasto de tokens e os custos de IA?
O gasto de tokens mede a quantidade de trabalho de IA que uma equipa faz, contabilizada em tokens. Os custos de IA abrangem tudo o que uma equipa paga para usar IA, incluindo subscrições, créditos extra e configuração. O gasto de tokens determina a parte dessa fatura que se baseia na utilização.
Os utilizadores com subscrição pagam por token?
Normalmente, não diretamente. As ferramentas por subscrição contabilizam a utilização em mensagens, consultas ou créditos, e as tarefas que usam mais tokens esgotam-nos mais depressa. Na Perplexity, as pesquisas normais não usam quaisquer créditos; só as tarefas do Computer os usam.
Porque é que os agentes de IA usam tantos tokens?
Um agente conclui uma tarefa em muitos passos, e cada passo é um pedido separado que volta a ler o trabalho feito até então. Por isso, uma tarefa longa usa mais tokens a cada passo que dá.
Porque é que a utilização de tokens dispara de repente?
A maior parte dos picos surge depois de uma mudança na forma como uma equipa trabalha, como um novo fluxo de trabalho automatizado, uma ferramenta disponibilizada a mais pessoas ou uma tarefa longa de agente. Comparar a data do pico com lançamentos recentes costuma revelar a causa. Testar primeiro os novos fluxos de trabalho com um grupo pequeno ajuda a evitar picos.