
Cum să urmărești și să controlezi consumul de tokenuri al echipei
Cum pot echipele să își vadă utilizarea tokenurilor în tablouri de bord și rapoarte, ce tipuri de activități AI folosesc cele mai multe tokenuri și cum pot folosi controalele pentru a o reduce.
Ce este consumul de tokenuri
Consumul de tokenuri reprezintă numărul de tokenuri pe care o echipă le consumă când folosește AI, precum și costul acestora. Un token este o unitate de text, cum ar fi un cuvânt, o parte dintr-un cuvânt sau un semn de punctuație, pe care un model AI o citește sau o scrie. În limba engleză, 1 token are aproximativ 4 caractere. Tokenurile nu sunt standardizate între modele sau furnizori, așa că același text poate genera un număr diferit de tokenuri în instrumente diferite.
Rapoartele de utilizare împart de obicei tokenurile în câteva tipuri:
- Tokenurile de intrare reprezintă tot ce citește modelul pentru o solicitare. Aici intră interogarea, orice text atașat și istoricul conversației pe care modelul îl reutilizează din mesajele anterioare ale aceluiași fir.
- Tokenurile de ieșire reprezintă răspunsul pe care îl scrie modelul. Adesea, acestea costă mai mult decât tokenurile de intrare. Conform prețurilor API Perplexity, unele modele taxează de șase ori mai mult pentru ieșire.
- Tokenurile de raționament reprezintă textul pe care un model îl generează intern pentru a rezolva o problemă înainte de a răspunde. Acestea nu apar în răspuns, așa că un răspuns vizibil mai lung nu înseamnă neapărat că modelul a folosit mai multe tokenuri în total.
Echipele care folosesc instrumente AI pe bază de abonament văd rareori o taxă per token. Totuși, tokenurile influențează ce primesc, deoarece sarcinile mai solicitante consumă creditele sau ating limitele de utilizare mai repede. Echipele care își construiesc propriile instrumente pe baza unui model AI plătesc de obicei per token, în cadrul unui model de tarifare bazată pe utilizare.
Cum să urmărești consumul de tokenuri
Urmărirea consumului de tokenuri într-un plan cu abonament
Instrumentele cu abonament de obicei nu afișează numărul de tokenuri. În schimb, multe planuri folosesc credite, unități preplătite care se deduc din plan pe măsură ce se lucrează. Creditele nu sunt același lucru cu tokenurile, deoarece un credit poate acoperi text, imagini sau alte tipuri de activitate. Însă sarcinile care folosesc mai multe tokenuri folosesc de obicei și mai multe credite, așa că acestea sunt cel mai bun indicator al consumului de tokenuri într-un abonament. Utilizatorii își pot urmări propriul consum de credite, iar unele planuri includ și un tablou de bord pentru administratori care arată consumul de credite al întregii echipe.
În Perplexity, de exemplu, căutările obișnuite nu folosesc credite. Doar Perplexity Computer, asistentul care gestionează sarcini în mai mulți pași, le folosește. Cei care folosesc Computer pot vedea câte credite au folosit și pentru ce. Fiecare sarcină Computer își afișează și propriul total de credite în meniul „Utilizare” al conversației sale.
În planurile Enterprise, administratorii pot vedea câte persoane folosesc Perplexity și câte interogări efectuează acestea în fiecare săptămână în tabloul de bord Insights (disponibil pentru organizațiile cu 50 sau mai multe locuri ori cu cel puțin un membru Enterprise Max).
Urmărirea consumului de tokenuri în rapoartele de utilizare API
Rapoartele de utilizare ale furnizorului API afișează direct numărul de tokenuri, de obicei împărțit pe tipuri. Consola API Platform de la Perplexity, de exemplu, le permite utilizatorilor să urmărească pe pagina „Facturare” indicatori precum consumul de tokenuri de intrare, de ieșire și de raționament.
De ce crește consumul de tokenuri
Agenții rulează mulți pași pentru fiecare sarcină, iar fiecare pas este o solicitare separată către un model. O singură sarcină poate ajunge la sute de mii sau chiar milioane de tokenuri.
Modelele de raționament devin, de asemenea, tot mai răspândite. Un model de raționament își scrie raționamentul înainte de a răspunde, iar fiecare cuvânt din acesta se contabilizează în tokenuri. Așadar, aceeași solicitare folosește de obicei mai multe tokenuri pe un model de raționament decât pe unul standard, chiar dacă răspunsul de pe ecran pare la fel de lung.
În sfârșit, pe măsură ce tot mai mulți oameni și fluxuri de lucru folosesc AI în general, utilizarea tokenurilor se acumulează. O parte din această creștere vine și din tokenmaxxing, practica prin care inginerii rulează agenți în principal pentru a-și crește numărul personal de tokenuri și a urca în clasamentele interne de tokenuri.
Cum să reduci consumul de tokenuri
Cea mai mare parte a consumului ridicat de tokenuri provine din câteva tipuri de activități care folosesc mai multe tokenuri decât par.
Conversații lungi și sarcini ale agenților
De fiecare dată când un model răspunde, de obicei recitește întreaga conversație de până atunci. Fiecare solicitare nouă include tot istoricul anterior al conversației, plus mesajul curent al utilizatorului. Așadar, o întrebare scurtă pusă târziu într-un fir lung folosește mai multe tokenuri decât aceeași întrebare pusă într-un fir nou. Sarcinile agenților funcționează la fel, deoarece fiecare pas își adaugă rezultatele la istoricul pe care pasul următor îl recitește.
Ce poți face
- Începe o conversație nouă atunci când se schimbă subiectul. Deschide-o cu un rezumat de două sau trei rânduri al informațiilor din firul vechi de care modelul are încă nevoie.
- Împarte sarcinile lungi ale agenților în sarcini mai mici. Rulează fiecare parte ca sarcină separată și transmite doar rezultatele de care are nevoie partea următoare.
- Verifică dacă instrumentele de agenți ale echipei folosesc compactarea contextului. Compactarea rezumă automat părțile mai vechi ale unei sarcini, astfel încât modelul să recitească mai puțin. Dacă un instrument o oferă ca setare, activeaz-o.
Aceleași documente procesate iar și iar
Când cineva atașează același fișier lung, cum ar fi un manual de politici sau un catalog de produse, la multe interogări separate, modelul citește de fiecare dată întregul fișier. Fiecare citire se contabilizează ca tokenuri de intrare.
Ce poți face
- Învață-i pe utilizatori să copieze în solicitare secțiunea relevantă dintr-un manual sau catalog, în loc să atașeze întregul fișier.
- Creează o versiune scurtă a documentelor pe care echipa le folosește des. Un rezumat de o pagină al unei politici lungi poate înlocui documentul complet în interogările de rutină.
Reîncercări și bucle
Când un răspuns nu este ceea ce avea nevoie cineva și acesta rulează din nou sarcina, fiecare încercare folosește tokenuri. Același lucru se întâmplă când un agent se blochează repetând același pas.
Ce poți face
- Descrie clar sarcina, rezultatul și sursele încă din prima solicitare. De exemplu: „Rezumă în cinci puncte principalele motive pentru care clienții au anulat în T3, folosind doar rezultatele sondajului atașat”.
- Verifică primii pași ai unei sarcini de agent. Dacă agentul repetă același pas sau aceeași căutare, oprește-l și repornește-l cu o solicitare mai precisă.
Modele mari pentru sarcini simple
Modelele mai performante costă de obicei mai mult per token, așa că activitățile de rutină, cum ar fi rezumatele sau reformatarea, pot consuma bugetul echipei mai repede decât este necesar.
Ce poți face
- Folosește rutarea modelelor, care atribuie fiecărei sarcini un model capabil să o gestioneze. O reformulare scurtă sau un rezumat pot fi trimise unui model mai mic și mai ieftin, iar cel mai performant model este păstrat pentru raționamente sau analize în mai mulți pași. API-ul Perplexity adoptă această abordare prin presetările sale, care atribuie un model mai mic unei căutări rapide și unul mai mare unei analize exhaustive.
Creșteri bruște după fluxuri de lucru noi
Un nou flux de lucru automatizat sau un instrument implementat pentru o echipă întreagă poate crește utilizarea peste noapte. O creștere bruscă nu este o problemă în sine, dar merită să știi ce activitate a provocat-o.
Ce poți face
- Testează mai întâi fluxurile de lucru noi cu un grup mic. Verifică utilizarea grupului timp de una sau două săptămâni înainte de a implementa fluxul de lucru pentru întreaga echipă.
- Stabilește un buget lunar pentru fiecare echipă. Bazează-l pe utilizarea dintr-o lună obișnuită, astfel încât orice salt să iasă în evidență.
- Dezactivează reîncărcarea automată. Când reîncărcarea automată este dezactivată, activitatea se oprește atunci când se epuizează creditele, în loc să se cumpere automat mai multe credite.
Cum să optimizezi consumul de tokenuri în Perplexity
Pentru utilizarea zilnică
Computer folosește credite, dar rulează doar când îl alegi, fie selectând pictograma Computer, fie lucrând într-un proiect care folosește implicit Computer, fie folosind modul Work din Comet.
Pentru a reveni la căutarea obișnuită, selectează pictograma Perplexity ca să treci înapoi la modul Ask. Pentru a vedea consumul de credite, utilizatorii pot deschide instrumentul de urmărire din interfața Perplexity.
Echipele care lucrează în proiecte, spațiile de lucru partajate din Perplexity, pot seta modul implicit al fiecărui proiect la Search sau Computer. Un proiect folosit mai ales pentru cercetări rapide poate avea implicit modul Search, astfel încât nimeni să nu pornească din greșeală o sarcină Computer.
Pentru administratorii Enterprise
- Află ce include fiecare loc. Utilizatorii Enterprise Pro primesc o alocare lunară de 500 de credite, iar utilizatorii Enterprise Max primesc 15.000 de credite. Acestea expiră la sfârșitul fiecărui ciclu lunar și nu se reportează.
- Setează mai întâi o limită de utilizare implicită. O limită de utilizare plafonează numărul de credite suplimentare pe care un membru le poate folosi din fondul comun după ce i se epuizează propria alocare.
- Creează limite denumite pentru diferite tipuri de utilizatori. Administratorii pot configura limite precum „Standard”, „Utilizator avansat” și „Colaborator extern” și le pot atribui unor grupuri de utilizatori sau unor membri individuali. Grupurile pot fi create în Perplexity sau sincronizate din furnizorul de identitate al companiei. Dacă cineva aparține mai multor grupuri, se aplică limita cea mai mare.
- Folosește suprascrieri personale pentru excepții. Când o persoană are nevoie de un plafon diferit de cel al grupului său, o suprascriere personală are prioritate față de orice limită de grup sau comună. Acest lucru este util pentru un proiect scurt cu multă cercetare, fără a crește plafonul pentru o echipă întreagă.
- Stabilește un plafon pentru reîncărcarea automată. Reîncărcarea automată completează automat fondul comun. Aceasta vine cu o limită lunară de reîncărcare configurabilă, astfel încât cheltuielile să nu poată crește fără un maxim stabilit.
- Decide cum pot cere membrii mai multe credite. Setarea „Permite membrilor să solicite mai multe credite” le permite celor care și-au atins limita să solicite mai multe credite de la un administrator, în loc să fie opriți complet.
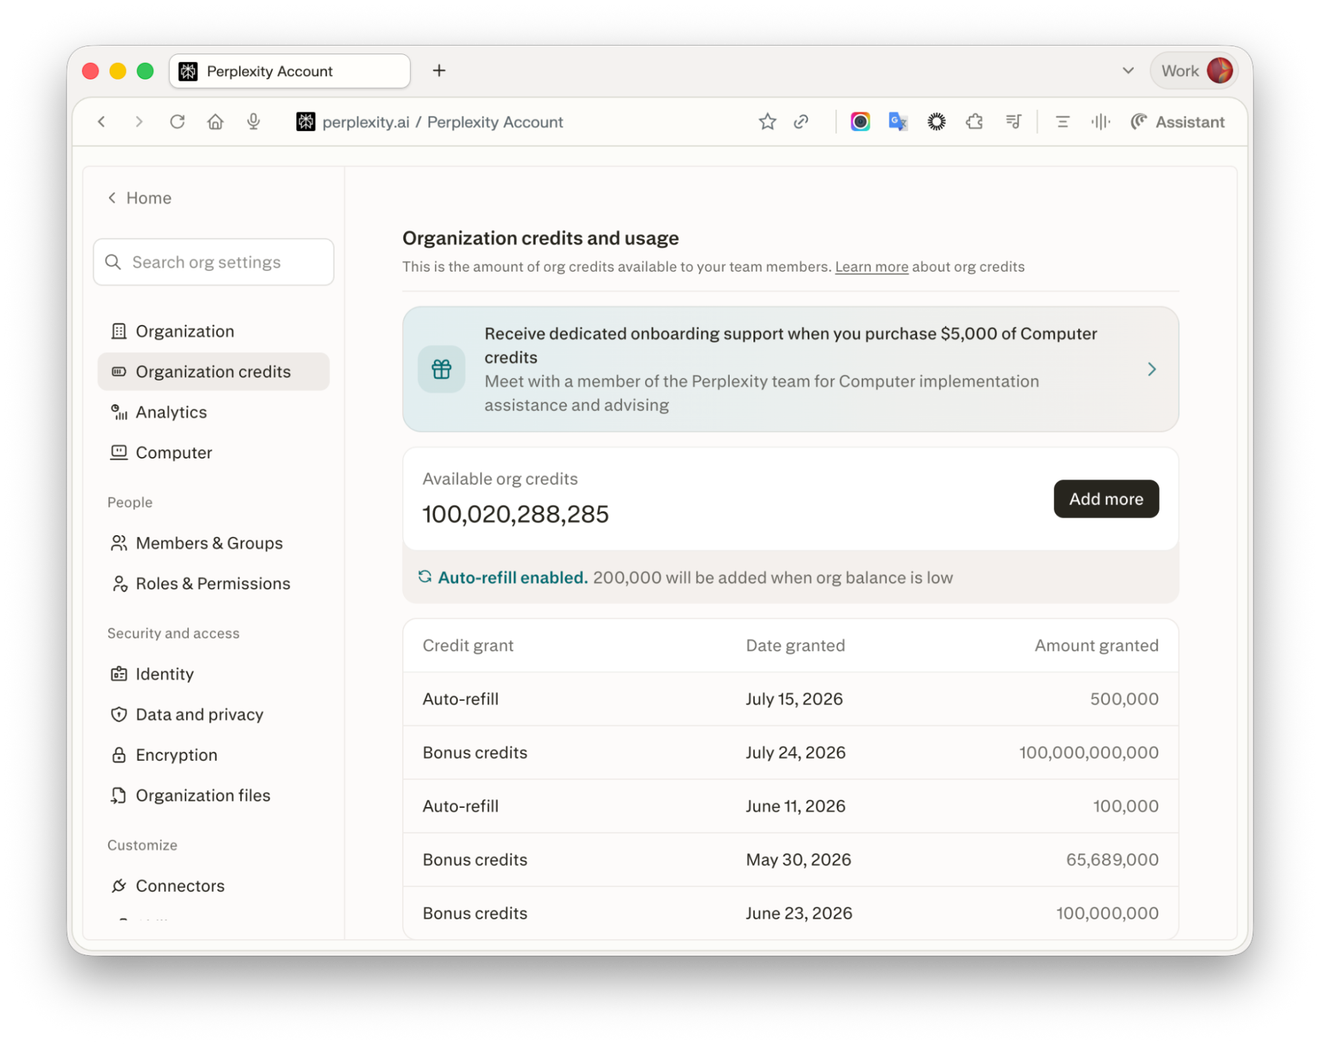
- Verifică utilizarea în fiecare lună. Pagina „Creditele organizației” afișează creditele acordate, folosite și rămase pentru fiecare membru, împreună cu limitele de grup și soldul fondului comun. Pentru organizațiile cu 50 sau mai multe locuri ori cu cel puțin un membru Enterprise Max, tabloul de bord Insights adaugă utilizatorii activi lunar și interogările săptămânale în timp. Pentru mai multe detalii, jurnalele de audit înregistrează execuția sarcinilor, utilizarea conectorilor, consumul de credite și acordarea de credite.
Pentru echipele care dezvoltă pe baza API-ului
- Oferă fiecărui instrument sau fiecărei echipe propria cheie API. Perplexity poate afișa separat facturarea pentru fiecare cheie, iar cheile separate arată clar ce instrument generează utilizarea.
- Verifică pe pagina de facturare ce tip de token este în creștere. Aceasta afișează tokenurile de intrare, de ieșire și de raționament în timp. Creșterea tokenurilor de intrare înseamnă de obicei că un instrument trimite mai mult text decât are nevoie. Creșterea tokenurilor de raționament înseamnă că sarcinile rulează pe modele care analizează problemele pe larg.
- Folosește Search API atunci când un instrument are nevoie doar de rezultate de căutare. Acesta returnează rezultate web fără ca un model să scrie un răspuns și taxează per solicitare, fără costuri suplimentare bazate pe tokenuri.
- Pornește instrumentele de agenți de la o presetare. Presetările Perplexity potrivesc dimensiunea modelului cu dimensiunea sarcinii și țin solicitările simple departe de cele mai scumpe modele
Prioritate pentru lucrul local
Unele activități nu au nevoie deloc de un model cloud plătit. Portable Computer este o versiune a agentului Perplexity care rulează pe computerul personal al utilizatorului, folosind un model AI stocat pe acel dispozitiv. Deoarece modelul rulează local, activitățile de rutină nu folosesc tokenuri plătite. Acesta accesează webul, aplicațiile conectate sau un model cloud mai puternic doar atunci când o sarcină o necesită și solicită mai întâi acordul utilizatorului.
Descoperă cum gestionează Perplexity Computer activitățile în mai mulți pași pe web, în fișiere și în instrumentele conectate.
Întrebări frecvente
Care este diferența dintre consumul de tokenuri și costurile AI?
Consumul de tokenuri măsoară cât de multă activitate AI desfășoară o echipă, exprimată în tokenuri. Costurile AI acoperă tot ce plătește o echipă pentru a folosi AI, inclusiv abonamentele, creditele suplimentare și configurarea. Consumul de tokenuri determină partea bazată pe utilizare a acestei facturi.
Utilizatorii cu abonament plătesc per token?
De obicei, nu direct. Instrumentele cu abonament urmăresc utilizarea în mesaje, interogări sau credite, iar sarcinile care folosesc mai multe tokenuri le consumă mai repede. În Perplexity, căutările obișnuite nu folosesc deloc credite; doar sarcinile Computer le folosesc.
De ce folosesc agenții AI atât de multe tokenuri?
Un agent finalizează o sarcină în mulți pași, iar fiecare pas este o solicitare separată care recitește activitatea de până atunci. Prin urmare, o sarcină lungă folosește tot mai multe tokenuri cu fiecare pas pe care îl face.
De ce crește brusc utilizarea tokenurilor?
Majoritatea creșterilor bruște apar după o schimbare în modul de lucru al echipei, cum ar fi un nou flux de lucru automatizat, un instrument implementat pentru mai multe persoane sau o sarcină lungă a unui agent. Compararea datei creșterii cu lansările recente arată de obicei cauza. Testarea fluxurilor de lucru noi mai întâi cu un grup mic ajută la prevenirea creșterilor bruște.