
Degradácia kontextu u AI agentov: prečo dlhé úlohy strácajú presnosť a ako tomu predísť
Sprievodca tým, čo sa hromadí v kontexte AI agenta, prečo to znižuje presnosť a ako nastaviť úlohy, ktoré zostanú spoľahlivé.
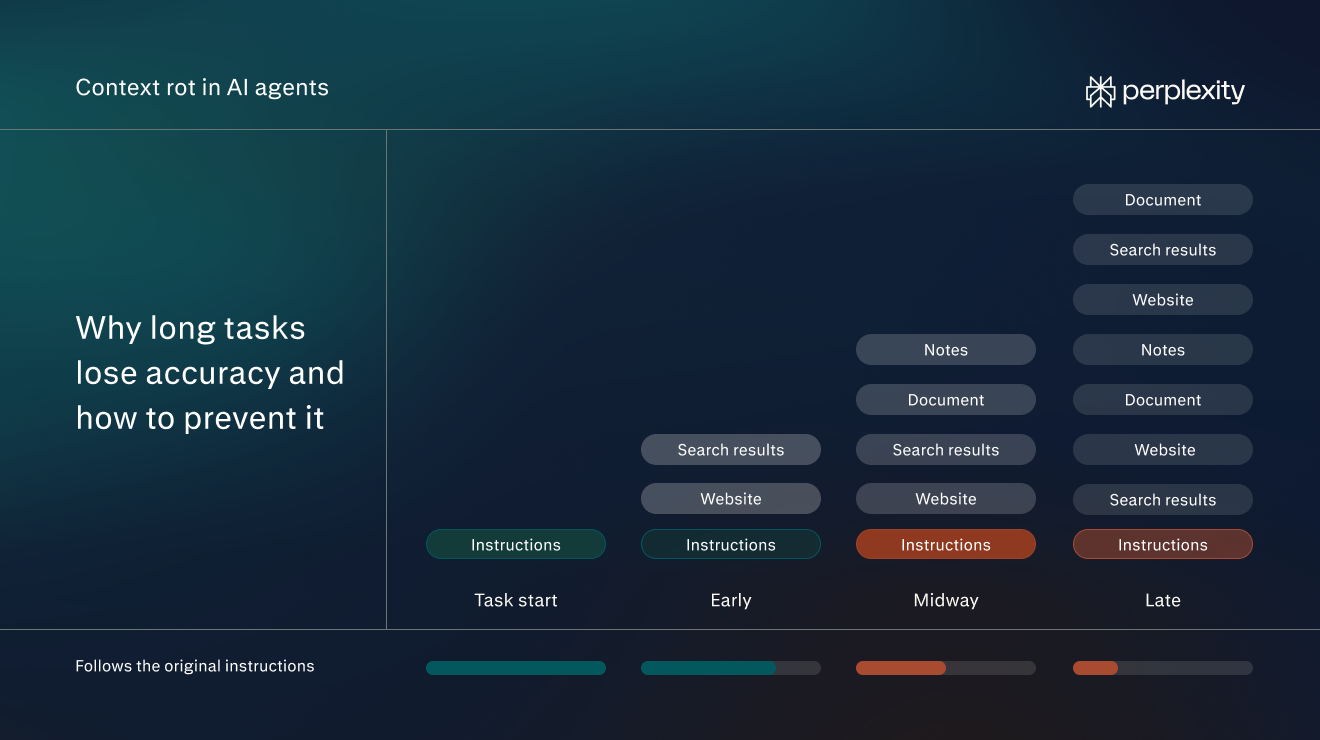
Čo znamená degradácia kontextu pre AI agentov
Degradácia kontextu (angl. context rot) u AI agentov je postupná strata presnosti, ku ktorej dochádza, keď sa počas dlhej úlohy zapĺňa kontext agenta.
Kontext agenta tvoria informácie, ktoré má model k dispozícii pre ďalší krok. Môže zahŕňať pokyny, predchádzajúce správy, výsledky vyhľadávania a text z webových stránok alebo súborov. Počas práce k nemu agent môže pridávať ďalšie.
Povedzme napríklad, že úlohou agenta je nájsť dodávateľov, ktorí dodávajú do dvoch týždňov. Na začiatku obsahuje jeho kontext len túto požiadavku. V polovici úlohy bude kontext obsahovať aj text desiatok webových stránok dodávateľov, niekoľko strán výsledkov vyhľadávania a poznámky o tom, ktorých dodávateľov už agent skontroloval.
Množstvo kontextu, ktoré model dokáže pojať, je obmedzené (tento limit sa nazýva kontextové okno). Okno sa meria v tokenoch, čo sú malé kúsky textu, zvyčajne slovo alebo časť slova. Degradácia kontextu sa zhoršuje s rastom kontextu, a preto sa najčastejšie vyskytuje pri dlhých úlohách s mnohými krokmi.
S postupujúcou degradáciou kontextu bude agent menej presný. Môže sa menej dôsledne držať pôvodných pokynov, prehliadať detaily alebo si mýliť podobne vyzerajúce informácie s tými, ktoré potrebuje.
Agent môže napríklad začať zahŕňať dodávateľov, ktorým dodanie trvá šesť týždňov, hoci mal nájsť dodanie do dvoch týždňov. Pokyn je stále v jeho kontexte, ale už neovplyvňuje rozhodnutia agenta.
Degradácia kontextu nie je to isté ako jednoduché vyčerpanie miesta v kontextovom okne. Keď kontext úlohy prerastie okno, časť obsahu sa oreže alebo úloha zlyhá. Degradácia kontextu začína dávno pred týmto bodom, keď sa ešte všetko zmestí.
Nie je to ani to isté ako otrávenie kontextu (keď sa do kontextu agenta dostanú zavádzajúce alebo škodlivé informácie). Aj agent s presnými a úplnými informáciami môže trpieť degradáciou kontextu.
Prečo dochádza k degradácii kontextu
K degradácii kontextu dochádza, pretože pozornosť modelu je obmedzená, aj keď má v kontextovom okne ešte dostatok miesta. V AI modeloch je pozornosť (attention) odborný termín pre spôsob, akým model rozhoduje, z ktorých častí vstupu bude čerpať pri písaní každého slova odpovede. Všetky časti kontextu o túto pozornosť súperia. Čím viac textu, tým menej pozornosti dostane každá časť.
Spoločnosť Chroma napríklad zverejnila štúdiu o tom, ako dĺžka vstupu ovplyvňuje AI modely. Otestovala 18 modelov od spoločností Anthropic, OpenAI, Google a Alibaba. V jednom teste výskumníci ukryli vetu s radou o písaní do dlhej zbierky esejí. Potom sa modelu spýtali, aká to bola rada.
Test zopakovali mnohokrát a zakaždým pridali viac textu esejí. Veta ani otázka sa nikdy nezmenili. Menilo sa len množstvo textu okolo nich.
Čím viac textu museli modely prečítať, tým horšie si viedli. Toto zistenie platilo pre všetky testy v správe. Výskumníci predpokladajú, že pokles presnosti by bol ešte väčší pri reálnej práci s mnohými krokmi, akou je väčšina úloh agentov.
Ako môže degradácia kontextu ovplyvniť AI agentov
Degradácia kontextu sa zvyčajne prejaví jedným zo štyroch spôsobov:
Strata prehľadu o pôvodných pokynoch
V najjednoduchšom teste spoločnosti Chroma mali modely presne skopírovať dlhý reťazec opakujúcich sa slov, do ktorého bolo niekde vložené jedno odlišné slovo. Išlo o triviálnu úlohu s jasným pokynom. Napriek tomu výkon všetkých modelov s predlžujúcim sa textom klesal. Niektoré modely začali generovať slová, ktoré vo vstupe vôbec neboli.
Pri úlohe agenta používateľ zvyčajne na začiatku stanoví konkrétne obmedzenia, napríklad rozpočet alebo požadovaný formát. S rastúcim kontextom ich agent môže uplatňovať menej dôsledne. Príčinou je celková dĺžka kontextu, nie to, kde sa pokyn nachádza.
Prehliadnuté detaily zo stredu úlohy
Podľa štúdie Stanfordskej univerzity z roku 2023 využívajú AI modely informácie najspoľahlivejšie vtedy, keď sa nachádzajú na úplnom začiatku alebo na úplnom konci vstupu. V jednom teste výskumníci dali modelom súbor 20 dokumentov a položili otázku, na ktorú odpovedal len jeden z nich. Keď bol tento dokument prvý alebo posledný, modely zvyčajne odpoveď našli. Keď sa nachádzal v strede súboru, prehliadli ho oveľa častejšie. Výskumníci tento jav nazývajú pozičný efekt.
Rovnaký vzorec platí aj pre agentov. Informácie nájdené skôr počas úlohy sa môžu ocitnúť v strede dlhej konverzácie, kde ich niektoré modely využívajú ťažšie. V príklade s dodávateľmi môže v konečnom zozname chýbať dobrý dodávateľ, ktorého agent skontroloval v priebehu úlohy.
Zamieňanie podobných informácií
S rastúcim kontextom môžu agenti horšie rozpoznávať, ktoré informácie zodpovedajú ich pokynom. Povedzme napríklad, že používateľ zadal agentovi nájsť dodávateľov, ktorí dodávajú „do dvoch týždňov“. Na webovej stránke dodávateľa sa píše „doručenie do 14 kalendárnych dní od objednania“. Pri krátkej úlohe by agent pravdepodobne rozpoznal, že ide o to isté. Ak je však táto informácia zahrabaná medzi desiatkami ďalších stránok dodávateľov, je pravdepodobnejšie, že zhodu prehliadne.
Prípadne môže agent začať zahŕňať výsledky, ktoré nie sú relevantné. Povedzme, že agent hľadá dodávateľov kancelárskych stoličiek. Webová stránka jedného dodávateľa sľubuje dodanie do dvoch týždňov, ale len pri stoloch. Dodanie jeho stoličiek trvá šesť týždňov. Webová stránka používa rovnaké slová ako pokyn, takže agent môže dodávateľa aj tak zaradiť do zoznamu. Výskumníci takéto informácie nazývajú distraktor. Vyzerajú relevantne, ale nie sú, a preto súperia s informáciami, na ktorých záleží.
Štúdia spoločnosti Chroma zistila, že oba problémy sa zhoršovali s rastúcim množstvom okolitého textu.
Ťažko odhaliteľné chyby
Degradácia kontextu nevyvolá chybové hlásenie. Agent pokračuje v práci a odovzdá výstup, ktorý vyzerá hotovo. Preto sa jeho chyby ľahko prehliadnu.
V testoch spoločnosti Chroma mali tieto chyby dve podoby. Niekedy model sebaisto poskytol nesprávnu odpoveď. V príklade s prieskumom dodávateľov môže agent dodať prehľadný, dobre naformátovaný zoznam dodávateľov, ktorý obsahuje dodávateľa, ktorého dodacie podmienky si agent zle vyložil.
Inokedy model tvrdil, že nedokáže nájsť informácie, ktoré tam v skutočnosti boli. Agent by napríklad mohol dodať správu, že žiadny dodávateľ nespĺňa limit dvoch týždňov, hoci ho spĺňa niekoľko.
Ako nastaviť úlohy agenta, aby sa obmedzila degradácia kontextu
Správne nastavenie úloh minimalizuje vplyv degradácie kontextu a udrží agenta počas celej úlohy čo najpresnejším. Pomôcť môžu nasledujúce osvedčené postupy.
Formulujte úlohu ako zadanie
Vďaka jasnému zadaniu zostáva kontext menší. Agent vie, kedy je s prácou hotový, takže prestane zhromažďovať materiál, keď ho má dosť. Konkrétne požiadavky mu zároveň dávajú niečo konkrétne, s čím môže porovnať každú stránku. Agent tak ľahšie rozpozná správne informácie.
Pred odoslaním úlohy skontrolujte, či pokrýva tri veci:
- Úloha: čo má agent urobiť a vytvoriť, napríklad „nájdi dodávateľov a vráť užší výber“.
- Požiadavky: fakty, ktoré agent nemôže uhádnuť, napríklad rozpočet, termín, adresa doručenia a pre koho je výsledok určený.
- Výstup: formát, dĺžka a štruktúra, napríklad „tabuľka s názvom, cenou za stoličku a dodacou lehotou“.
Dopyt pre úlohu s dodávateľmi by po spojení všetkých častí mohol vyzerať takto:
„Nájdi 10 dodávateľov, ktorí dokážu do dvoch týždňov dodať 40 kancelárskych stoličiek do našej kancelárie v Chicagu za menej ako 250 $ za stoličku. Vráť tabuľku s názvom dodávateľa, cenou za stoličku, dodacou lehotou a odkazom na stránku produktu. Zoznam je pre nášho office manažéra, ktorý zadá objednávku.“
Každá úloha by mala mať jasné zameranie
Vďaka jednej úlohe s jedným jasným cieľom zostáva kontext malý. Dlhé úlohy sú navyše drahšie. Každý krok spracúva všetko, čo sa doteraz zhromaždilo, takže nafúknutý kontext spotrebuje v každom kroku viac kreditov.
Projekt s niekoľkými časťami rozdeľte:
- Vypíšte jednotlivé výstupy, napríklad vyhľadanie dodávateľov, porovnanie cien a e-mail vybranému dodávateľovi.
- Každý výstup spracujte ako samostatnú úlohu.
- Do ďalšej úlohy odovzdajte len hotový výsledok z predchádzajúcej. Napríklad tabuľku dodávateľov nahrajte ako súbor a začnite s ňou úlohu porovnania, namiesto toho, aby ste pokračovali vo vlákne, v ktorom vznikla.
Úloha porovnania potom začína jednou tabuľkou namiesto všetkých stránok.
Nasmerujte agenta na správne zdroje
Každá stránka, ktorú agent prečíta, rozširuje jeho kontext vrátane navigačných ponúk, reklám a štandardného textu okolo užitočnej časti. Ak agentovi poskytnete zdroje priamo, tento šum sa zníži.
Súbory, od ktorých úloha závisí, napríklad zoznam schválených dodávateľov, nahrajte priložením k dopytu. Keď musí agent vyhľadávať na webe, uveďte webové stránky, na ktorých sa oplatí hľadať, napríklad dva dôveryhodné adresáre dodávateľov.
Pripojte nástroje, v ktorých sa informácie nachádzajú. Napríklad v Perplexity Computer otvorte na bočnom paneli Konektory a povoľte aplikácie, ktoré úloha potrebuje, napríklad Google Drive alebo Slack. Potom ich spomeňte v dopyte: „Použi špecifikácie stoličiek z nášho Google Drive.“ Pripájajte len relevantné aplikácie, pretože každý konektor zaberá časť kontextu agenta.
Ak sa informácie nachádzajú v aplikácii, ktorá nie je v zozname Konektory, možno ju aj tak bude možné pripojiť. Mnohé aplikácie ponúkajú konektor MCP (Model Context Protocol), štandardný spôsob, ako sa AI nástroje pripájajú k inému softvéru. Computer ich môže používať spolu so svojimi vstavanými konektormi. Vo firemnom účte ich možno najprv musí povoliť správca.
Požiadajte o záverečnú kontrolu podľa pokynov
Dopyt ukončite krokom kontroly, ktorý uvádza najdôležitejšie obmedzenia:
„Pred dokončením skontroluj každého dodávateľa podľa týchto požiadaviek: dodanie do dvoch týždňov, menej ako 250 $ za stoličku. Tých, ktorí tieto požiadavky nespĺňajú, označ namiesto toho, aby si ich vynechal.“
Obmedzenia sú stále na začiatku kontextu. Krok kontroly dáva agentovi dôvod porovnať svoj konečný výstup s obmedzeniami namiesto toho, aby sa spoliehal na to, že pokyny si udržia vplyv počas všetkých krokov.
Požiadavka na označenie problémov namiesto jednoduchého vyradenia takýchto výsledkov zároveň uľahčuje odhalenie chýb (napríklad zamietnutia dodávateľa, ktorý sľubuje doručenie do 14 kalendárnych dní, len preto, že nepoužíva slová „dva týždne“).
Kontrolujte prácu v kontrolných bodoch
Pri dlhších úlohách zabudujte do dopytu kontrolný bod:
„Začni tým, že nájdeš 20 potenciálnych dodávateľov, a potom sa zastav. Zoznam potvrdím predtým, ako začneš zisťovať ceny.“
Skontrolujte užší výber podľa pôvodných pokynov. Čokoľvek nesprávne opravte v nadväzujúcej správe a potom nechajte agenta pokračovať. Chyby zachytené v tomto bode sa neprenesú do všetkých nasledujúcich krokov.
Keď sa úloha vychýli z kurzu, začnite novú
Ak agent po opravách opakuje tú istú chybu, začnite novú úlohu. Každá oprava pridáva ďalší text do už aj tak dlhého kontextu. Namiesto toho vytvorte novú úlohu. Zopakujte pokyny, nahrajte všetky dobré výstupy z prvého pokusu a začnite odznova.
Niektorí agenti robia určitú verziu tohto postupu automaticky – tento proces sa nazýva zhutňovanie (compaction). Keď sa úloha predlžuje, agent nahradí starší materiál, napríklad celý text stránok prečítaných na začiatku, krátkym zhrnutím toho, čo zistil. Portable Computer od spoločnosti Perplexity takto zhutňuje svoj kontext, aby model zostal v rozsahu, ktorý dokáže dobre zvládnuť.
Novú úlohu je dôležité začať aj vtedy, keď sa zmení cieľ. Vlákno, ktoré začalo ako vyhľadávanie dodávateľov, by sa nemalo zmeniť aj na kontrolu zmluvy.
Premeňte opakované pokyny na Skill
Niektoré pokyny sa objavujú v každej úlohe určitého typu, napríklad preferovaný formát tabuľky, zoznam dodávateľov, ktorým sa treba vyhnúť, alebo štandardný krok kontroly. V nástroji Computer ich možno uložiť ako Skill – opakovane použiteľnú sadu pokynov, ktorými sa agent zakaždým riadi. Skill zabuduje ostatné osvedčené postupy do každej úlohy, ktorá ho používa.
Ako ho nastaviť:
- Vyberte si úlohu, ktorá sa často opakuje, napríklad prieskum dodávateľov.
- Zapíšte si pokyny, ktoré zadávate zakaždým: formát, kontroly, zdroje, ktoré sa majú použiť alebo ktorým sa treba vyhnúť.
- Uložte ich ako Skill. Pokyny, ktoré už máte napísané v Markdowne, môžete importovať priamo.
- V budúcich dopytoch uveďte Skill menom: „Použi Skill na prieskum dodávateľov a nájdi dodávateľov stoličiek pre kanceláriu v Denveri.“
Ako Perplexity pristupuje ku kontextu pri práci agentov
Perplexity Computer zvláda dlhé úlohy spôsobmi, ktoré udržiavajú kontext každého modelu malý a relevantný. Tri prvky jeho návrhu obmedzujú, koľko musí model naraz prečítať.
Rozdelenie práce medzi podagentov
Computer rozdelí požiadavku na úlohy a podúlohy a potom vytvorí podagentov, ktorí ich vykonajú. Každý podagent pracuje na jednej časti práce vo vlastnom kontexte. Pri úlohe s dodávateľmi môže jeden podagent zisťovať ceny, zatiaľ čo iný kontroluje dodacie podmienky. Ani jeden nemusí čítať všetko, čo prečítal ten druhý.
Uchovávanie práce v súboroch
Každá úloha v nástroji Computer dostane vlastný pracovný priestor s vlastnými súbormi, webovým prehliadačom a nástrojmi. Agent môže svoju prácu uložiť do súboru, napríklad do priebežne aktualizovanej tabuľky dodávateľov, ktorých už skontroloval. Tento súbor potom znova otvorí, len keď ho potrebuje.
Výber relevantných pasáží z výsledkov vyhľadávania
Webové stránky sú plné materiálu, ktorý model nepotrebuje, napríklad navigačných ponúk, reklám, metadát a textu na iné témy. Kompresia kontextu s ohľadom na dopyt ho odstráni. Skôr ako sa stránka dostane k modelu, Perplexity ponechá len vety, ktoré súvisia s dopytom.
Preskúmajte tipy, návody a ukážkové úlohy pre Perplexity Computer a vyskúšajte tieto kroky v praxi.
Časté otázky
Je degradácia kontextu to isté ako halucinácia?
Nie, ale navzájom súvisia. Halucinácia je akákoľvek odpoveď, ktorá uvádza niečo nepravdivé alebo nepodložené. Degradácia kontextu je jednou z podmienok, ktoré zvyšujú pravdepodobnosť halucinácií, ako aj ďalších chýb, napríklad ignorovaných pokynov a prehliadnutých detailov.
Dá sa degradácia kontextu odstrániť lepším dopytom?
Jasný dopyt obmedzuje degradáciu kontextu tým, že udržiava úlohu zameranú. Rastu kontextu však zabrániť nedokáže. Pri dostatočne dlhej úlohe agent aj tak zhromaždí viac, než dokáže dobre využiť, a preto sú rozdelenie práce a jej priebežná kontrola rovnako dôležité ako samotný dopyt.
Ovplyvňuje degradácia kontextu aj bežné AI chaty, nielen agentov?
Áno. V chate tvorí kontext celá doterajšia konverzácia vrátane každej správy a všetkých dokumentov, ktoré do nej boli vložené alebo nahrané. Vlákno, ktoré beží hodiny a pokrýva niekoľko tém, môže viesť k rovnakým chybám ako dlhá úloha agenta. Ak pre novú tému začnete nové vlákno, každá konverzácia zostane zameraná.
Aká dlhá môže byť úloha, kým nastúpi degradácia kontextu?
Neexistuje pevná hranica. Závisí to od modelu a úlohy. Napríklad modely bežiace priamo v zariadení s kontextovým oknom 260 000 tokenov začínajú mať problémy nad hranicou približne 100 000 tokenov, teda hlboko pod svojím limitom. Pokles je navyše postupný, nie náhly.