
AI-minne: vad det är, hur det fungerar och vad det lagrar
En guide till AI-minne: hur AI-assistenter sparar och minns detaljer från tidigare konversationer, vad de lagrar, var minnet brister och hur du visar, redigerar eller stänger av det.
AI-minne är information som en konversationsbaserad AI-assistent sparar från dina tidigare konversationer och tar med in i nya, så att den kan komma ihåg dina preferenser och ditt sammanhang. Själva modellen behåller ingenting av det. Assistenten lagrar det separat och lägger till det igen när det är relevant, vilket ger modellen en beständig kontext som den annars skulle sakna.
Den här guiden förklarar hur assistenter sparar och hämtar den informationen, vad de lagrar, varför de ibland gör fel och hur du kan se, ändra eller stänga av den.
Vad är AI-minne?
AI-minne, även kallat beständigt minne, är en funktion i AI-assistenter som lagrar information om dig, till exempel preferenser, fakta och sammanhang från tidigare interaktioner, som assistenten kan använda i senare konversationer.
En AI-assistent kan bygga upp den informationen utifrån saker du ber den att komma ihåg, detaljer den själv uppfattar och tidigare chattar som den kan hänvisa tillbaka till.
AI-minneslagret gör det möjligt för AI-assistenter att ge personliga svar utan att du behöver dela dina preferenser i varje chatt. Om du har berättat för en assistent att du tränar inför ett maraton och föredrar kilometer får du svar i kilometer på din nästa fråga om tempo, utan att behöva upprepa det.
Jämfört med att beskriva din situation på nytt i varje chatt sparar minnet dig skrivande och håller prompten kort, vilket är viktigt eftersom långa indata gör svaren mindre exakta.
Minnet är inte en utskrift av varje konversation, utan en samling viktiga fakta om dig. Det kommer alltså ihåg att du föredrar kilometer. Om exakt det träningsprogram som assistenten tog fram förra månaden går att hitta beror på om den också kan söka i tidigare chattar.
Typer av AI-minne
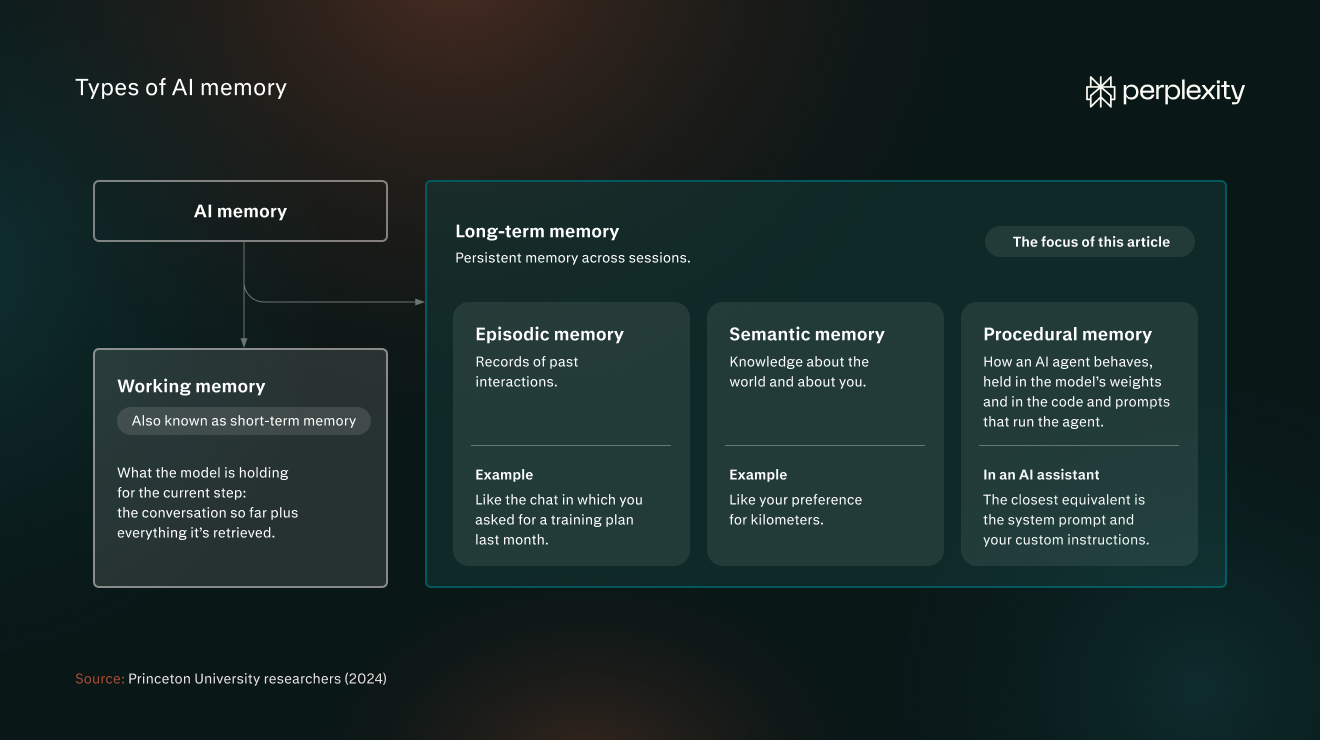
Forskare vid Princeton University (2024) har lånat terminologi från forskningen om mänskligt minne för att klassificera olika typer av AI-minnessystem. Deras ramverk skiljer arbetsminne från långtidsminne:
- Arbetsminne: Det som modellen håller kvar för det aktuella steget, alltså konversationen hittills plus allt den har hämtat. Kallas även korttidsminne.
- Långtidsminne: Beständigt minne mellan sessioner. Det är den typen av minne som den här artikeln handlar om.
Långtidsminnet består av tre minnestyper:
- Episodiskt minne: Uppgifter om tidigare interaktioner, till exempel chatten där du bad om ett träningsprogram förra månaden.
- Semantiskt minne: Kunskap om världen och om dig, till exempel att du föredrar kilometer.
- Procedurellt minne: Hur en AI-agent beter sig, inbyggt i modellens vikter och i den kod och de prompter som styr agenten. I en AI-assistent är systemprompten och dina anpassade instruktioner det som ligger närmast.
Minne hos AI-assistenter vs. minne hos AI-agenter
Minne hos AI-assistenter och minne hos AI-agenter är båda långtidsminne. En AI-assistents minne är främst semantiskt minne och lagrar fakta om dig, så att svaren passar dig. Agentminne, som Perplexitys Brain, lagrar vad agenten gjorde och hur det gick, inklusive vad som fungerade och vad du korrigerade, så att den börjar varje ny uppgift från ett bättre utgångsläge.
Minne hos AI-assistenter | Minne hos AI-agenter | |
Vad det kommer ihåg | Dig | Uppgiften och dess historik |
Vad det är till för | Svar som passar dig | Att fortsätta arbete i flera steg utan att börja om |
Exempel | Kommer ihåg att du föredrar kilometer | Kommer ihåg ditt träningsprogram för maraton, justeringar som har gjorts och de pass du har genomfört hittills, så att kommande träningsblock kan planeras bättre |
AI-minne jämfört med kontextfönster, träningsdata och anpassade instruktioner
AI-minne är lätt att förväxla med tre andra saker som påverkar ett svar: modellens kontextfönster, träningsdata och anpassade instruktioner. Var och en innehåller olika information, varar olika länge och styrs av olika system.
Ett kontextfönster är den mängd text som en stor språkmodell (LLM) kan läsa på en gång, och det omfattar den aktuella konversationen. Det nollställs när du startar en ny chatt.
Vissa nuvarande modeller har stora kontextfönster på en miljon token eller mer, så tekniskt sett skulle du kunna klistra in din viktigaste information i varje konversation. Men att bearbeta allt detta ökar latensen och kostnaden.
Flera studier har också visat att svarens noggrannhet minskar när indata växer, även när svaret finns i kontexten.
En studie från University of Illinois och Amazon från 2025 såg det även när modellerna kunde återge varje relevant detalj: noggrannheten sjönk med 13,9–85 % när indata växte till 30 000 token, långt under modellernas uppgivna gränser. NoLiMa, ett benchmark från 2025 av Adobe Research och LMU München, fann att 11 av de 13 testade modellerna presterade betydligt sämre redan vid 32 000 token när frågan och svaret inte hade några nyckelord gemensamt. Chromas rapport från juli 2025 såg det i 18 modeller, även när de svarade utifrån en chatthistorik på 113 000 token.
Träningsdata är den information som byggs in i modellens vikter innan den släpps. Användare kan inte ändra den. Utvecklare kan finjustera en modell med nya data, men det är en teknisk process, inte en användarinställning,
Anpassade instruktioner är regler som sparas i assistentens inställningar och som du själv skriver och redigerar för att anpassa AI-assistentens beteende och svar. Du kan till exempel använda anpassade instruktioner för att bestämma svarens ton och stil eller vilka källor assistenten får använda.
Så här står sig de fyra mot varandra:
Kontextfönster | AI-minne | Träningsdata | Anpassade instruktioner | |
Vad det innehåller | Meddelandena i den aktuella chatten | Sparade fakta och preferenser om dig | Det modellen lärde sig innan den släpptes | Riktlinjer som du skriver själv |
Hur länge det varar | Endast den här chatten | Tills det uppdateras eller raderas | Oförändrat tills en ny modell släpps | Tills du redigerar dem |
Vem som styr det | Du, inom de gränser som modellens leverantör sätter. | Du och assistenten | AI-företaget | Du |
Exempel | Frågan om tempo som du ställde för en minut sedan | Att du föredrar kilometer | Hur träningsprogram för maraton i allmänhet är uppbyggda | Instruktion om att formatera träningsprogram i ett rutnät där raderna motsvarar veckor och kolumnerna veckodagar |
Vad AI-minnet lagrar
Assistenter sparar utvalda detaljer om dig, till exempel fakta, preferenser och sammanfattningar, och vissa använder även dina tidigare chattar.
- Fakta och preferenser som du ber den att komma ihåg: Det här är detaljer som du uttryckligen ber assistenten att spara, till exempel ”kom ihåg att jag föredrar kilometer”. Assistenten skapar minnet när du ber om det, och det finns kvar tills du raderar det eller en senare konversation uppdaterar det.
- Detaljer som den uppfattar från dina konversationer: Assistenten sparar dessa när inställningen är aktiverad. Perplexity ”prioriterar hur ofta användaren ställer frågor och lämnar information”, så något du nämner ofta har större chans att fastna än något du nämner en gång. Minnet finns kvar tills det uppdateras eller du raderar det.
- Hänvisningar till dina tidigare chattar: Assistenten använder tidigare konversationer direkt i stället för en sparad lista. Perplexity kallar detta sökhistorik: dina tidigare frågor och svar, som används för att göra ett nytt svar mer relevant.
Hur AI-minne fungerar
AI-modellen kommer inte ihåg något mellan konversationer. Det arbetet sköts av AI-minnessystemet: det sparar uppgifter om dig separat och lägger till de relevanta delarna i varje ny konversation. Lagring och hämtning sker i bakgrunden, så att modellen läser dem tillsammans med din fråga.
Processen sker i fem steg:
- Sparande: Assistenten sparar ett minne när du ber den om det, eller när den bedömer att en detalj är värd att behålla.
- Lagring: Minnena hamnar i en databas som hålls separat från modellen. I många system är det en vektordatabas, så att de kan sökas efter betydelse. Listan du ser i inställningarna är en vy av det minnesarkivet.
- Hämtning: När du skickar ett meddelande avgör assistenten vilka minnen som är relevanta. Många system gör detta genom att omvandla ditt meddelande och varje minne till inbäddningar (embeddings), numeriska representationer av betydelse, och välja de närmaste matchningarna. Det är så de kan hämta ett minne även när det inte har några ord gemensamt med din fråga. Enklare system läser in alla sparade minnen i varje konversation.
- Användning: Hämtade minnen infogas som ren text i indata, oftast i ett block med instruktioner som modellen läser före ditt meddelande. Modellen bearbetar dem som all annan text i dessa indata.
- Uppdatering och borttagning: Assistenten extraherar fakta från chattar, söker igenom befintliga minnen och avgör om uppgiften ska läggas till som ett nytt minne, uppdatera ett befintligt minne, slås ihop med ett befintligt minne eller om ett gammalt minne som motsäger de nya uppgifterna ska raderas. Vissa assistenter tidsstämplar varje minne för att kunna skilja nyare information från äldre.
Utmaningar och risker med AI-minne
AI-minne är avsett att förbättra svarens kvalitet, men benchmarks visar att minneshämtningen inte alltid lyfter fram relevant eller aktuell information, särskilt från stora databaser. Det medför också säkerhets- och integritetsrisker.
Vanliga problem med tillförlitlighet och säkerhet kopplade till AI-minne är bland annat:
- Felaktigt tillämpade minnen: Ett minne kan dras in i ett svar som det inte har något med att göra. En studie från 2026 testade 18 modeller för att se om ett sparat minne från ett livsområde läckte in i ett svar inom ett annat. Medianen för andelen misslyckanden var 53 %. Studien fann också att när minnet innehöll användarnas övertygelser eller påstådda expertis upprepade nästan alla modeller dem, även om frågan krävde ett neutralt svar.
- Inaktuella minnen: Assistenten fortsätter att agera utifrån en detalj efter att en senare konversation har gjort den felaktig, särskilt när du aldrig sa det rakt ut. I ett benchmark från maj 2026, som testade om modeller märker sådana underförstådda förändringar, nådde den bästa modellen i genomsnitt 55,2 %.
- Minnesöverbelastning: Ju mer en assistent måste läsa igenom, desto svårare är det att urskilja det som är viktigt. LongMemEval, ett benchmark från 2024, fann att modeller som läste en chatthistorik på cirka 115 000 token presterade 30–60 % sämre än modeller som bara fick de relevanta sessionerna.
- Minnesförgiftning: Falsk information eller dolda instruktioner hamnar i en assistents minne, till exempel via innehåll som du ber den att läsa, vilket leder till partiska eller osäkra svar eller dataläckor.
- Integritetsrisker: Minnet behåller personliga uppgifter utöver den chatt de kom från, ibland längre än du förväntar dig. Perplexity kan till exempel spara en logg över raderade minnen i upp till 30 dagar av säkerhetsskäl och för felsökning. Dataskyddslagstiftningen behandlar lagrade minnen som personuppgifter, så du ska kunna granska och radera dem.
Så visar, redigerar och stänger du av AI-minne
Du kan se vad en assistent har sparat, radera det, stänga av minnet eller använda en privat chatt som inte skapar minnen.
Minneshantering handlar om ett fåtal funktioner. Så här fungerar var och en och när du ska använda dem:
Funktion | Vad den gör | När den ska användas |
Se vad som har sparats | Öppnar din minnesbank, där du kan söka, filtrera och granska enskilda poster. | När ett svar innehåller en detalj som du inte förväntade dig. |
Radera ett minne | Tar bort posten, och assistenten slutar använda den i senare svar (assistenter kan spara en logg över raderade minnen under en viss tid). | När ett minne är felaktigt, inaktuellt eller känsligt. |
Stäng av minnet | Gör att assistenten slutar använda minnet i framtida svar (det kanske inte raderar minnen som redan har lagrats – kontrollera vad som gäller för din assistent). | När du vill ha svar utan personalisering |
Stäng av sökhistorik | Gör att assistenten slutar använda dina tidigare frågor och svar. Om du raderar en session från din sökhistorik påverkar den inte längre senare svar. | När tidigare konversationer styr svaren vill du börja om från början. |
Använd en inkognitochatt | Minne och sökhistorik är alltid avstängda, och frågor som ställs där sparas aldrig och används aldrig i minnet. | För enstaka eller känsliga ämnen. |
Om du vill börja helt från början stänger du av minnet och rensar det som har sparats.
Så hanterar Perplexity minne
Minnet i Perplexity fungerar med alla modeller som Perplexity erbjuder.
Perplexity anpassar svaren utifrån två källor: minnen, som är de preferenser och detaljer du delar, och din sökhistorik. När ett minne påverkar ett svar visas det bland svarets källor, så att du kan se vilka minnen som användes och radera vilka av dem du vill.
Du kan också anpassa dina svar genom att ange uppgifter om dig själv och genom att ge anpassade instruktioner för projekt (varje projekt har sitt eget minneslager).
Perplexity kan använda minnesinnehåll för att förbättra sina modeller på konsumentkonton (aldrig på Enterprise-konton) om du inte stänger av det (AI-datalagring under Inställningar → Preferenser → Artificiell intelligens).
Prenumeranter på Max och Enterprise Max får också Brain, ett delat minneslager som bygger vidare på minnet genom att hålla koll på dina projekt och ditt arbete. Det har ett eget reglage och ignorerar inkognitosessioner.
Prova Perplexity och se hur minnen formar ditt nästa svar.
Vanliga frågor om AI-minne
Vad är begränsat minne inom AI?
IBM definierar AI med begränsat minne som AI som kan minnas tidigare händelser och utfall och övervaka situationer över tid, men som inte kan spara dessa data i ett långsiktigt bibliotek av tidigare erfarenheter. Det är en av fyra kategorier i en taxonomi över AI-system, och IBM placerar chattbottar och virtuella assistenter i den.
Assistentminne är ett externt minne som dessa system lägger till ovanpå. Det finns kvar mellan sessioner, så att en assistent kan använda detaljer som du delade i en tidigare konversation.
Vilken AI-assistent har bäst minne?
Ingen enskild assistent är bäst för alla. Ett bra minne är ett som du kan styra, så utvärdera AI-verktyg genom att ställa fyra frågor: Kan du se vad som har sparats? Kan du radera ett minne separat från chatten det kom från? Är träning en inställning som är skild från minnet? Finns det ett tillfälligt läge eller inkognitoläge som inte skapar några minnen?
Lär sig en AI-modell av det den minns om dig?
Att använda minnet i ett svar är en annan process än träning. Perplexity uppger att tjänsten hämtar relevant kontext från ditt minnesarkiv i stället för att behandla din historik som träningsdata. Huruvida ditt innehåll får användas för att förbättra modeller är en separat inställning. På konsumentkonton kan Perplexity använda minnesinnehåll i det syftet, och det stängs av med AI-datalagring.
Vad bör du hålla utanför AI-minnet?
Håll allt som du inte vill ska sparas, användas för att profilera dig eller upprepas senare utanför AI-minnet: identitets- och ekonomiuppgifter, hälsoinformation, lösenord, andra personers uppgifter och allt som rör barn. Kanadas Office of the Privacy Commissioner (maj 2025) och brittiska National Cyber Security Centre (mars 2023) rekommenderar att du avstår från alla prompter som skulle orsaka problem om de blev offentliga.
Filter minskar integritetsriskerna, men garanterar inte att dina hälso- eller ekonomiuppgifter inte lagras alls, så gå igenom din minnesbank och använd inkognito för enstaka känsliga frågor.