
Kontextförfall hos AI-agenter: därför tappar långa uppgifter noggrannhet och så förebygger du det
En guide till vad som byggs upp i en AI-agents kontext, varför det försämrar noggrannheten och hur du lägger upp uppgifter som förblir tillförlitliga.
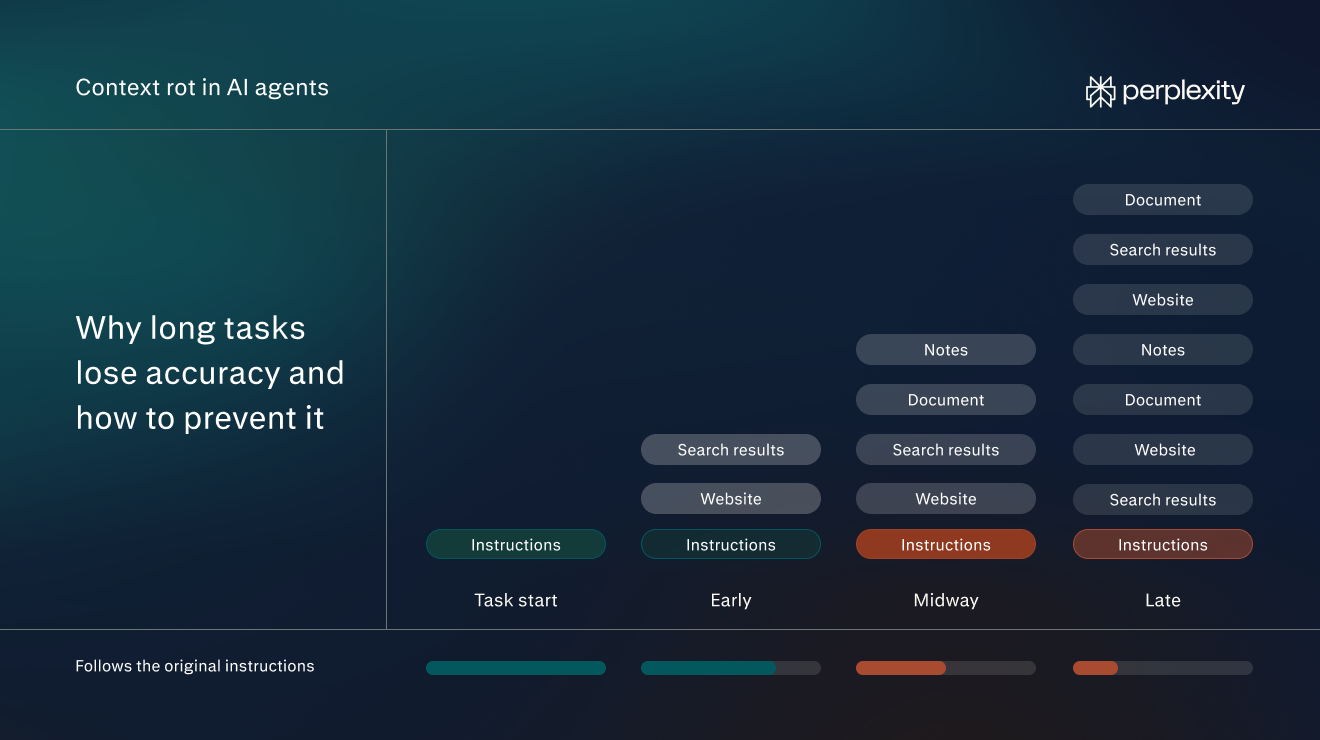
Vad kontextförfall innebär för AI-agenter
Kontextförfall hos AI-agenter är den gradvisa förlust av noggrannhet som uppstår när en agents kontext fylls på under en lång uppgift.
En agents kontext är den information som modellen har tillgång till inför sitt nästa steg. Den kan omfatta instruktioner, tidigare meddelanden, sökresultat och text från webbplatser eller filer. Allt eftersom agenten arbetar kan den lägga till mer.
Anta till exempel att en agent har i uppgift att hitta leverantörer som levererar inom två veckor. I början innehåller kontexten bara den förfrågan. Halvvägs genom uppgiften innehåller kontexten dessutom texten från dussintals leverantörers webbplatser, flera sidor med sökresultat och anteckningar om vilka leverantörer agenten redan har kontrollerat.
Det finns en gräns för hur mycket kontext en modell kan rymma (kallas kontextfönstret). Fönstret mäts i token, som är små textbitar, oftast ett ord eller en del av ett ord. Kontextförfallet ökar i takt med att kontexten växer, och därför uppstår det oftast i långa uppgifter med många steg.
När kontextförfallet förvärras blir agenten mindre noggrann. Den kan följa sina ursprungliga instruktioner mindre noga, förbise detaljer eller ta information som bara liknar det den behöver för rätt information.
Agenten kan till exempel börja ta med leverantörer som behöver sex veckor, trots att den fick i uppdrag att hitta leverans inom två veckor. Instruktionen finns fortfarande kvar i kontexten, men den styr inte längre agentens val.
Kontextförfall är inte samma sak som att helt enkelt få slut på utrymme i kontextfönstret. När en uppgifts kontext växer förbi fönstret klipps material bort eller så misslyckas uppgiften. Kontextförfall börjar långt före den punkten, medan allt fortfarande får plats.
Det är inte heller samma sak som kontextförgiftning (när vilseledande eller skadlig information hamnar i agentens kontext). En agent med korrekt och fullständig information kan ändå drabbas av kontextförfall.
Varför kontextförfall uppstår
Kontextförfall uppstår eftersom en modells uppmärksamhet är begränsad, även när kontextfönstret har gott om utrymme kvar. Inom AI-modeller är uppmärksamhet den tekniska termen för hur en modell avgör vilka delar av sin indata den ska utgå från när den skriver varje ord i ett svar. Alla delar av kontexten konkurrerar om den uppmärksamheten. Ju mer text det finns, desto mindre uppmärksamhet får varje del.
Chroma publicerade till exempel en studie om hur indatalängd påverkar AI-modeller. Den testade 18 modeller från Anthropic, OpenAI, Google och Alibaba. I ett test gömde forskarna en mening med ett skrivråd i en lång samling essäer. Sedan frågade de modellen vad rådet var.
De körde testet många gånger och lade till mer essätext varje gång. Meningen och frågan ändrades aldrig. Det enda som ändrades var mängden text runt dem.
Ju mer text modellerna behövde läsa, desto sämre presterade de. Detta resultat gällde i alla tester i rapporten. Forskarna förutspår att noggrannheten skulle sjunka ännu mer i verkligt arbete som kräver många steg, som de flesta agentuppgifter.
Hur kontextförfall kan påverka AI-agenter
Kontextförfall visar sig oftast på ett av fyra sätt:
Att tappa bort de ursprungliga instruktionerna
Chromas enklaste test bad modellerna att exakt kopiera en lång sträng av upprepade ord, med ett avvikande ord insatt någonstans i den. Det var en trivial uppgift med en tydlig instruktion. Trots det försämrades prestandan för alla modeller när texten blev längre. Vissa modeller började generera ord som inte alls fanns i indatan.
I en agentuppgift anger användaren oftast specifika begränsningar i början av uppgiften, till exempel en budget eller ett obligatoriskt format. Agenten kan tillämpa dem mindre konsekvent när kontexten växer. Orsaken är kontextens totala längd, inte var instruktionen står.
Missade detaljer från mitten av en uppgift
AI-modeller använder information mest tillförlitligt när den står allra först eller allra sist i deras indata, enligt en studie från Stanford 2023. I ett test gav forskarna modellerna en uppsättning med 20 dokument och ställde en fråga som bara ett av dem besvarade. När det dokumentet kom först eller sist hittade modellerna oftast svaret. När det låg i mitten av uppsättningen missade de det betydligt oftare. Forskare kallar detta en positionseffekt.
Samma mönster gäller för agenter. Information som hittades tidigare i en uppgift kan hamna i mitten av en lång konversation, där vissa modeller har svårare att använda den. I leverantörsexemplet kan den slutliga listan utelämna en bra leverantör som agenten kontrollerade halvvägs genom uppgiften.
Att blanda ihop liknande information
När kontexten växer kan agenter bli sämre på att känna igen vilken information som stämmer med deras instruktioner. Anta till exempel att användaren bad agenten hitta leverantörer som levererar ”inom två veckor”. En leverantörs webbplats anger ”levereras inom 14 kalenderdagar från beställning”. I en kort uppgift skulle en agent sannolikt inse att dessa betyder samma sak. Begravd bland dussintals andra leverantörssidor är det mer sannolikt att den missar matchningen.
Agenten kan också börja ta med resultat som inte är relevanta. Anta att agenten letar efter leverantörer av kontorsstolar. En leverantörs webbplats utlovar leverans inom två veckor, men bara för skrivbord. Dess stolar tar sex veckor. Webbplatsen använder samma ord som instruktionen, så agenten kan ändå lägga till leverantören i sin lista. Forskare kallar sådan information för en distraktor. Den ser relevant ut men är det inte, och därför konkurrerar den med den information som spelar roll.
Chromas studie visade att båda problemen förvärrades när mängden omgivande text ökade.
Fel som är svåra att upptäcka
Kontextförfall utlöser inget felmeddelande. Agenten fortsätter arbeta och lämnar tillbaka resultat som ser färdiga ut. Det gör att dess misstag är lätta att missa.
I Chromas tester tog sig dessa misstag uttryck på två sätt. Ibland gav en modell ett självsäkert svar som var fel. I exemplet med leverantörsundersökningen kan agenten leverera en snygg, välformaterad leverantörslista som innehåller en leverantör vars leveransvillkor den har misstolkat.
Andra gånger uppgav en modell att den inte kunde hitta information som faktiskt fanns där. Agenten kan till exempel leverera en rapport som säger att inga leverantörer klarar gränsen på två veckor, när flera faktiskt gör det.
Så lägger du upp agentuppgifter för att minska kontextförfall
Om du lägger upp uppgifterna rätt minimerar du effekten av kontextförfall och håller agenten så noggrann som möjligt under hela uppgiften. Följande beprövade metoder kan hjälpa.
Formulera uppgiften som ett uppdrag
Ett tydligt uppdrag håller kontexten mindre. Agenten vet när den är klar, så den slutar samla material när den har tillräckligt. Specifika krav ger den också något konkret att jämföra varje sida mot. Det gör det lättare för agenten att hitta rätt information.
Kontrollera att en uppgift täcker tre saker innan du skickar den:
- Uppgiften: vad agenten ska göra och ta fram, till exempel ”hitta leverantörer och returnera en kortlista”.
- Kraven: de fakta som agenten inte kan gissa sig till, till exempel budget, deadline, leveransadress och vem resultatet är till för.
- Resultatet: format, längd och struktur, till exempel ”en tabell med namn, pris per stol och leveranstid”.
Sammantaget kan frågan för leverantörsuppgiften se ut så här:
”Hitta 10 leverantörer som kan leverera 40 kontorsstolar till vårt kontor i Chicago inom två veckor, för under 250 dollar per stol. Returnera en tabell med leverantörsnamn, pris per stol, leveranstid och en länk till produktsidan. Listan är till för vår kontorschef, som kommer att lägga beställningen.”
Håll varje uppgift fokuserad
En uppgift med ett tydligt mål håller kontexten liten. Långa uppgifter kostar också mer. Varje steg bearbetar allt som har samlats in hittills, så en uppsvälld kontext förbrukar fler krediter i varje steg.
Om ett projekt har flera delar, dela upp det:
- Lista de separata leveranserna, till exempel en leverantörssökning, en prisjämförelse och ett e-postmeddelande till den valda leverantören.
- Kör varje leverans som en egen uppgift.
- Skicka bara vidare det färdiga resultatet från en uppgift till nästa. Ladda till exempel upp leverantörstabellen som en fil för att starta jämförelseuppgiften, i stället för att fortsätta i den tråd som tog fram den.
Jämförelseuppgiften börjar då med en enda tabell i stället för alla sidor.
Hänvisa agenten till rätt källor
Varje sida som agenten läser bidrar till dess kontext, inklusive menyer, annonser och standardtext runt den användbara delen. Om du ger agenten dess källor direkt minskar du det bruset.
Ladda upp filer som uppgiften är beroende av, till exempel listan över godkända leverantörer, genom att bifoga dem till frågan. Ange vilka webbplatser som är värda att söka på när agenten måste söka på webben, till exempel två betrodda leverantörskataloger.
Anslut verktygen där informationen finns. I Perplexity Computer öppnar du till exempel Anslutningar i sidofältet och aktiverar de appar som uppgiften behöver, till exempel Google Drive eller Slack. Nämn dem sedan i frågan: ”Använd stolspecifikationerna i vår Google Drive.” Anslut bara relevanta appar, eftersom varje anslutning tar upp en del av agentens kontext.
Om informationen finns i en app som inte står med i listan Anslutningar kan det ändå vara möjligt att ansluta den. Många appar erbjuder en MCP-anslutning (Model Context Protocol), ett standardiserat sätt för AI-verktyg att kopplas till annan programvara. Computer kan använda dessa tillsammans med sina inbyggda anslutningar. I ett företagskonto kan en administratör behöva aktivera dem först.
Be om en slutkontroll mot instruktionerna
Avsluta frågan med ett granskningssteg som anger de begränsningar som är viktigast:
”Innan du avslutar, kontrollera varje leverantör mot dessa krav: leverans inom två veckor, under 250 dollar per stol. Flagga de leverantörer som inte uppfyller kraven i stället för att utelämna dem.”
Begränsningarna står fortfarande i början av kontexten. Granskningssteget ger agenten en anledning att jämföra sitt slutliga resultat med begränsningarna, i stället för att förlita sig på att instruktionerna behåller sitt inflytande genom varje steg.
Samtidigt gör en uppmaning att flagga problem, i stället för att bara stryka de resultaten, att misstag blir lättare att upptäcka (till exempel att en leverantör som utlovar leverans inom 14 kalenderdagar avvisas för att den inte använder orden ”två veckor”).
Granska arbetet vid kontrollpunkter
Vid längre uppgifter kan du bygga in en kontrollpunkt i frågan:
”Börja med att hitta 20 tänkbara leverantörer och stanna sedan. Jag bekräftar listan innan du samlar in priser.”
Kontrollera kortlistan mot de ursprungliga instruktionerna. Rätta det som är fel i ett uppföljande meddelande och låt sedan agenten fortsätta. Misstag som upptäcks i det här skedet följer inte med till alla efterföljande steg.
Starta en ny uppgift när en uppgift spårar ur
Om agenten upprepar samma misstag efter rättelser, starta en ny uppgift. Varje rättelse lägger till mer text i en redan lång kontext. Skapa en ny uppgift i stället. Upprepa instruktionerna, ladda upp eventuella bra resultat från första försöket och börja om.
Vissa agenter gör en variant av detta automatiskt, en process som kallas komprimering. När en uppgift blir lång ersätter agenten äldre material, till exempel hela texten från sidor den läste tidigt, med en kort sammanfattning av vad den hittade. Perplexitys Portable Computer komprimerar sin kontext på det här sättet, så att modellen håller sig inom den mängd den kan hantera väl.
Det är också viktigt att starta en ny uppgift om målet ändras. En tråd som började som en leverantörssökning bör inte också bli en avtalsgranskning.
Gör återkommande instruktioner till en Skill
Vissa instruktioner återkommer i varje uppgift av ett visst slag, till exempel ett föredraget tabellformat, en lista över leverantörer att undvika eller ett standardiserat granskningssteg. I Computer kan dessa sparas som en Skill, en återanvändbar uppsättning instruktioner som agenten följer varje gång. En Skill bygger in de andra beprövade metoderna i varje uppgift som använder den.
Så här skapar du en:
- Välj en uppgift som ofta återkommer, till exempel leverantörsundersökningar.
- Skriv ned de instruktioner som ges varje gång: formatet, kontrollerna, källorna att använda eller undvika.
- Spara dem som en Skill. Instruktioner som redan är skrivna i Markdown kan importeras direkt.
- Hänvisa till din Skill med namn i framtida frågor: ”Använd Skill för leverantörsundersökning för att hitta stolleverantörer till kontoret i Denver.”
Så hanterar Perplexity kontext i agentarbete
Perplexity Computer hanterar långa uppgifter på sätt som håller varje modells kontext liten och relevant. Tre delar av dess design begränsar hur mycket en modell behöver läsa på en gång.
Att dela upp arbetet mellan underagenter
Computer delar upp en förfrågan i uppgifter och deluppgifter och skapar sedan underagenter som utför dem. Varje underagent arbetar med en del av jobbet i sin egen kontext. I leverantörsuppgiften kan en underagent undersöka priser medan en annan kontrollerar leveransvillkor. Ingen av dem behöver läsa allt som den andra har läst.
Att spara arbetet i filer
Varje uppgift i Computer får sin egen arbetsyta, med egna filer, egen webbläsare och egna verktyg. Agenten kan spara sitt arbete i en fil, till exempel en löpande tabell över de leverantörer den har kontrollerat. Den öppnar sedan filen igen först när den behöver den.
Att välja ut relevanta avsnitt ur sökresultat
Webbsidor är fulla av material som modellen inte behöver, till exempel menyer, annonser, metadata och text om andra ämnen. Frågemedveten kontextkomprimering rensar bort det. Innan en sida når modellen behåller Perplexity bara de meningar som hör ihop med frågan.
Utforska tips, guider och exempeluppgifter för Perplexity Computer för att omsätta de här stegen i praktiken.
Vanliga frågor
Är kontextförfall samma sak som hallucination?
Nej, men de hänger ihop. En hallucination är ett svar som påstår något felaktigt eller ogrundat. Kontextförfall är ett av de tillstånd som gör hallucinationer mer sannolika, tillsammans med andra misstag som ignorerade instruktioner och missade detaljer.
Kan en bättre fråga åtgärda kontextförfall?
En tydlig fråga minskar kontextförfall genom att hålla uppgiften fokuserad. Den kan dock inte hindra kontexten från att växa. Vid en tillräckligt lång uppgift samlar agenten ändå in mer än den kan använda väl, och därför är det lika viktigt att dela upp arbetet och kontrollera det längs vägen som själva frågan.
Påverkar kontextförfall vanliga AI-chattar, inte bara agenter?
Ja. I en chatt är kontexten hela konversationen hittills, inklusive alla meddelanden och alla dokument som klistrats in eller laddats upp i den. En tråd som har pågått i timmar och spänt över flera ämnen kan ge samma misstag som en lång agentuppgift. Om du startar en ny tråd för ett nytt ämne håller du varje konversation fokuserad.
Hur lång kan en uppgift bli innan kontextförfall sätter in?
Det finns ingen fast gräns. Det beror på modellen och uppgiften. Modeller som körs på enheten med kontextfönster på 260 000 token börjar till exempel få problem bortom cirka 100 000 token, långt innan de når sin gräns. Försämringen sker också gradvis snarare än plötsligt.