
Så spårar och styr du teamets tokenförbrukning
Hur team kan se sin tokenanvändning i instrumentpaneler och rapporter, vilka typer av AI-arbete som använder flest tokens och hur kontroller kan användas för att minska den.
Vad är tokenförbrukning
Tokenförbrukning är antalet tokens som ett team förbrukar med AI, och vad dessa tokens kostar. En token är en textenhet, till exempel ett ord, en del av ett ord eller ett skiljetecken, som en AI-modell läser eller skriver. På engelska motsvarar 1 token ungefär 4 tecken. Tokens är inte standardiserade mellan modeller eller leverantörer, så samma text kan ge olika antal tokens i olika verktyg.
Användningsrapporter delar vanligtvis in tokens i några typer:
- Indatatokens är allt som modellen läser för en förfrågan. Det omfattar frågan, eventuell bifogad text och konversationshistorik som modellen återanvänder från tidigare i samma tråd.
- Utdatatokens är svaret som modellen skriver. De kostar ofta mer än indatatokens. I Perplexitys API-prissättning tar vissa modeller betalt sex gånger så mycket för utdata.
- Resonemangstokens är text som en modell genererar internt för att arbeta sig igenom ett problem innan den svarar. De syns inte i svaret, så ett längre synligt svar betyder inte nödvändigtvis att en modell har använt fler tokens totalt.
Team som använder AI-verktyg via en prenumeration ser sällan en avgift per token. Tokens påverkar ändå vad de får, eftersom tyngre uppgifter förbrukar krediter eller når användningsgränser snabbare. Team som bygger egna verktyg på en AI-modell betalar i stället vanligtvis per token, enligt användningsbaserad prissättning.
Så spårar du tokenförbrukning
Spåra tokenförbrukning med en prenumerationsplan
Prenumerationsverktyg visar vanligtvis inte antalet tokens. I stället använder många planer krediter, förbetalda enheter som dras från planen allteftersom arbetet utförs. Krediter är inte samma sak som tokens, eftersom en kredit kan täcka text, bilder eller annat arbete. Men uppgifter som använder fler tokens förbrukar oftast också fler krediter, så krediterna är den bästa indikatorn på tokenförbrukningen i en prenumeration. Användare kan följa sin egen kreditanvändning, och vissa planer har även en administratörspanel som visar kreditanvändningen för hela teamet.
I Perplexity förbrukar till exempel vanliga sökningar inga krediter. Det är bara Perplexity Computer, assistenten som hanterar uppgifter i flera steg, som använder dem. Personer som använder Computer kan se hur många krediter de har använt och vad de har använt dem till. Varje Computer-uppgift visar också sin egen kreditsumma i menyn ”Användning” i konversationen.
I Enterprise-planer kan administratörer se hur många personer som använder Perplexity och hur många frågor de ställer varje vecka i Insights-instrumentpanelen (tillgänglig för organisationer med 50 eller fler licenser, eller minst en Enterprise Max-medlem).
Spåra tokenförbrukning i API-användningsrapporter
API-leverantörens användningsrapporter visar antalet tokens direkt, vanligtvis uppdelat efter tokentyp. I Perplexitys API Platform-konsol kan användare till exempel följa mätvärden som förbrukning av indata-, utdata- och resonemangstokens på sidan Fakturering.
Därför ökar tokenförbrukningen
Agenter kör många steg per uppgift, och varje steg är en separat förfrågan till en modell. En enda uppgift kan uppgå till hundratusentals eller till och med miljontals tokens.
Resonemangsmodeller blir också allt vanligare. En resonemangsmodell skriver ut sitt resonemang innan den svarar, och varje ord av det räknas som tokens. Samma förfrågan använder därför vanligtvis fler tokens med en resonemangsmodell än med en standardmodell, även om svaret på skärmen ser lika långt ut.
Slutligen ökar tokenanvändningen i takt med att fler personer och arbetsflöden använder AI i allmänhet. En del av ökningen kommer också från tokenmaxxing, där ingenjörer kör agenter främst för att öka sitt personliga antal tokens och klättra på interna topplistor över tokenanvändning.
Så minskar du tokenförbrukningen
Hög tokenförbrukning beror oftast på ett fåtal typer av arbete som använder fler tokens än det verkar.
Långa konversationer och agentuppgifter
Varje gång en modell svarar läser den vanligtvis om hela konversationen dittills. Varje ny förfrågan innehåller all tidigare konversationshistorik plus det aktuella användarmeddelandet. En kort fråga sent i en lång tråd använder därför fler tokens än samma fråga i en ny tråd. Agentuppgifter fungerar på samma sätt, eftersom varje steg lägger till sina resultat i historiken som nästa steg läser om.
Vad du kan göra åt det
- Starta en ny konversation när ämnet byts. Inled den med en sammanfattning på två eller tre rader av det från den gamla tråden som modellen fortfarande behöver.
- Dela upp långa agentuppgifter i mindre delar. Kör varje del som en egen uppgift och skicka bara vidare de resultat som nästa del behöver.
- Kontrollera om teamets agentverktyg använder kontextkomprimering. Komprimeringen sammanfattar automatiskt äldre delar av en uppgift så att modellen behöver läsa om mindre. Om ett verktyg erbjuder detta som en inställning ska du aktivera den.
Samma dokument bearbetas om och om igen
När någon bifogar samma långa fil, till exempel en policyhandbok eller en produktkatalog, till många separata frågor läser modellen hela filen varje gång. Varje läsning räknas som indatatokens.
Vad du kan göra åt det
- Lär användarna att kopiera det relevanta avsnittet i en handbok eller katalog till förfrågan i stället för att bifoga hela filen.
- Skapa kortversioner av dokument som teamet använder ofta. En sammanfattning på en sida av en lång policy kan ersätta hela dokumentet i rutinmässiga frågor.
Omförsök och loopar
När ett svar inte blir det som behövdes och uppgiften körs igen förbrukar varje försök tokens. Detsamma händer när en agent fastnar och upprepar samma steg.
Vad du kan göra åt det
- Formulera uppgiften, resultatet och källorna tydligt i den första förfrågan. Till exempel: ”Sammanfatta de främsta orsakerna till att kunder sa upp sina prenumerationer under Q3, med enbart de bifogade enkätresultaten, i fem punkter.”
- Kontrollera de första stegen i en agentuppgift. Om agenten upprepar samma steg eller sökning stoppar du den och startar om med en snävare förfrågan.
Stora modeller för enkla uppgifter
Mer kapabla modeller kostar oftast mer per token, så rutinarbete som sammanfattningar eller omformatering kan förbruka teamets budget snabbare än nödvändigt.
Vad du kan göra åt det
- Använd modellroutning, som matchar varje uppgift med en modell som klarar den. En kort omskrivning eller sammanfattning kan gå till en mindre, billigare modell, medan den mest kapabla modellen sparas för resonemang eller analys i flera steg. Perplexitys API använder den här metoden med sina förinställningar, som tilldelar en snabb uppslagning en mindre modell och en uttömmande analys en större.
Toppar efter nya arbetsflöden
Ett nytt automatiserat arbetsflöde, eller ett verktyg som rullas ut till ett helt team, kan få användningen att öka över en natt. En topp är inget problem i sig, men det är bra att veta vilket arbete som orsakade den.
Vad du kan göra åt det
- Testa nya arbetsflöden med en liten grupp först. Följ gruppens användning i en eller två veckor innan arbetsflödet rullas ut till hela teamet.
- Sätt en månadsbudget för varje team. Basera den på användningen under en typisk månad, så att ett hopp sticker ut.
- Stäng av automatisk påfyllning. När automatisk påfyllning är avstängd stoppas arbetet när krediterna tar slut, i stället för att fler krediter köps automatiskt.
Så optimerar du tokenförbrukningen i Perplexity
För vardaglig användning
Computer använder krediter, men körs bara när du väljer det, antingen genom att välja Computer-ikonen, arbeta i ett projekt som har Computer som standard eller använda Work-läget i Comet.
Om du vill gå tillbaka till vanlig sökning väljer du Perplexity-ikonen för att växla tillbaka till Ask-läget. För att se kreditanvändningen kan användare öppna spåraren i Perplexitys gränssnitt.
Team som arbetar i projekt, Perplexitys delade arbetsytor, kan ställa in standardläget för varje projekt till Sök eller Computer. Ett projekt som främst används för snabba efterforskningar kan ha Sök som standard, så att ingen startar en Computer-uppgift av misstag.
För Enterprise-administratörer
- Ta reda på vad varje licens omfattar. Enterprise Pro-användare får en månatlig tilldelning på 500 krediter och Enterprise Max-användare får 15 000 krediter. Krediterna upphör att gälla i slutet av varje månadscykel och förs inte över till nästa.
- Ställ in en standardgräns för användning först. En användningsgräns begränsar hur många extra krediter en medlem kan ta från den delade poolen när den egna tilldelningen har tagit slut.
- Skapa namngivna gränser för olika typer av användare. Administratörer kan skapa gränser som ”Standard”, ”Avancerad användare” och ”Konsult” och tilldela dem till användargrupper eller enskilda medlemmar. Grupper kan komma från Perplexity eller synkroniseras från företagets identitetsleverantör. Om någon tillhör mer än en grupp gäller den högsta gränsen.
- Använd personliga åsidosättningar för undantag. När en person behöver ett annat tak än sin grupp har en personlig åsidosättning företräde framför alla grupp- eller delade gränser. Det är användbart för ett kort projekt med omfattande efterforskningar, utan att höja taket för ett helt team.
- Sätt ett tak för automatisk påfyllning. Automatisk påfyllning fyller på den delade poolen automatiskt. Den har en konfigurerbar månatlig påfyllningsgräns, så att utgifterna inte kan växa utan ett fastställt maximum.
- Bestäm hur medlemmar ber om mer. Med inställningen Tillåt medlemmar att begära fler krediter kan personer som når sin gräns begära fler från en administratör i stället för att stoppas helt.
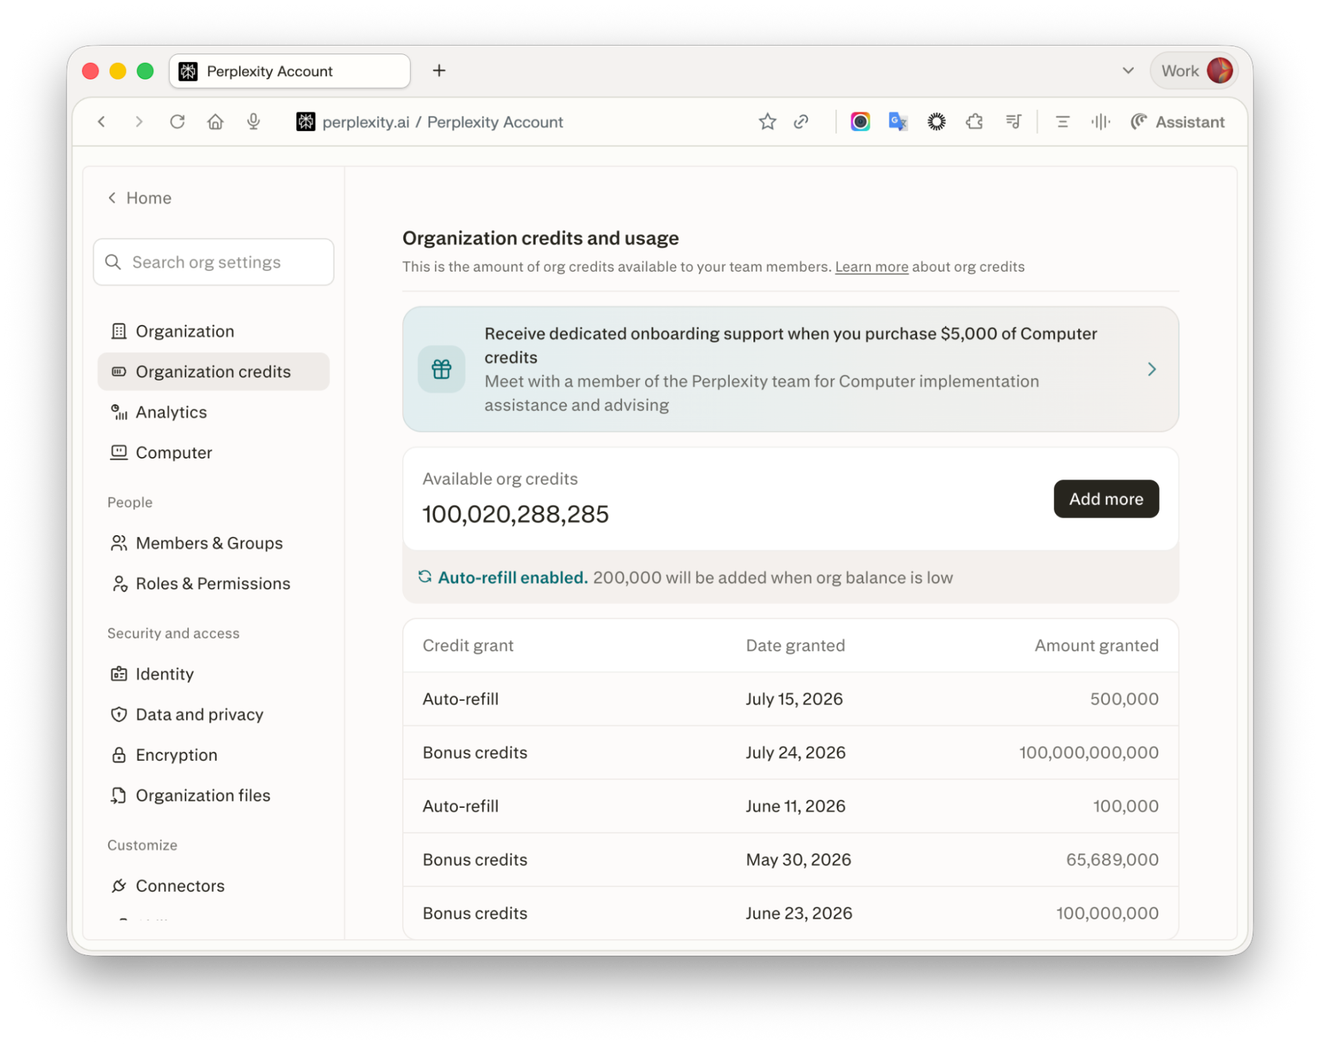
- Granska användningen varje månad. Sidan Organisationskrediter visar beviljade, använda och återstående krediter för varje medlem, tillsammans med gruppgränser och poolens saldo. För organisationer med 50 eller fler licenser, eller minst en Enterprise Max-medlem, visar Insights-instrumentpanelen dessutom månatligt aktiva användare och veckovisa frågor över tid. För mer detaljer registrerar granskningsloggar uppgiftskörning, användning av anslutningar, kreditförbrukning och kredittilldelningar.
För team som bygger på API:et
- Ge varje verktyg eller team en egen API-nyckel. Perplexity kan visa fakturering för varje nyckel separat, och separata nycklar gör det tydligt vilket verktyg som driver användningen.
- Kontrollera på faktureringssidan vilken typ av token som ökar. Den visar indata-, utdata- och resonemangstokens över tid. Ökande indatatokens betyder oftast att ett verktyg skickar mer text än nödvändigt. Ökande resonemangstokens betyder att uppgifter körs på modeller som tänker igenom problem utförligt.
- Använd Search API när ett verktyg bara behöver sökresultat. Det returnerar webbresultat utan att en modell skriver ett svar och debiterar per förfrågan utan ytterligare tokenbaserade avgifter.
- Starta agentverktyg från en förinställning. Perplexitys förinställningar anpassar modellens storlek efter uppgiftens storlek och håller enkla förfrågningar borta från de dyraste modellerna.
Arbeta lokalt först
En del arbete behöver inte någon betald molnmodell alls. Portable Computer är en version av Perplexitys agent som körs på användarens egen dator, med en AI-modell som är lagrad på den datorn. Eftersom modellen körs lokalt förbrukar rutinarbete inga betalda tokens. Den ansluter till webben, anslutna appar eller en kraftfullare molnmodell bara när en uppgift kräver det, och frågar användaren först.
Utforska hur Perplexity Computer hanterar arbete i flera steg på webben, i filer och i anslutna verktyg.
Vanliga frågor
Vad är skillnaden mellan tokenförbrukning och AI-kostnader?
Tokenförbrukning mäter hur mycket AI-arbete ett team utför, räknat i tokens. AI-kostnader omfattar allt ett team betalar för att använda AI, inklusive prenumerationer, extra krediter och konfiguration. Tokenförbrukningen styr den användningsbaserade delen av den kostnaden.
Betalar prenumerationsanvändare per token?
Vanligtvis inte direkt. Prenumerationsverktyg mäter användningen i meddelanden, frågor eller krediter, och uppgifter som använder fler tokens förbrukar dem snabbare. I Perplexity förbrukar vanliga sökningar inga krediter alls – det gör bara Computer-uppgifter.
Varför använder AI-agenter så många tokens?
En agent utför en uppgift i många steg, och varje steg är en separat förfrågan som läser om arbetet hittills. En lång uppgift använder därför fler tokens för varje steg den tar.
Varför ökar tokenanvändningen plötsligt?
De flesta toppar följer på en förändring i hur ett team arbetar, till exempel ett nytt automatiserat arbetsflöde, ett verktyg som rullas ut till fler personer eller en lång agentuppgift. Om du jämför datumet för toppen med nyligen gjorda lanseringar framgår orsaken oftast. Att testa nya arbetsflöden med en liten grupp först hjälper till att förebygga toppar.