
搜尋引擎類型:爬蟲、元搜尋與 AI 答案引擎
爬蟲式搜尋引擎、元搜尋引擎及 AI 答案引擎如何尋找並返回結果,另介紹其他類型的搜尋引擎,涵蓋注重私隱、付費、垂直、地區及企業搜尋引擎。
各類搜尋引擎的主要分別,在於它們從哪裡取得資訊,以及會返回哪類結果。
爬蟲式搜尋引擎會搜尋自行建立的索引,而元搜尋引擎則會整合多個其他搜尋引擎的結果。AI 答案引擎同樣使用已編入索引的來源,但與其他類型不同,它們不會提供一列連結,而是運用這些資訊撰寫度身訂造的答案。
以下會舉例說明三種主要搜尋引擎的運作方式。我們亦會介紹你可能遇到的其他類型(注重私隱、付費、垂直、地區及企業搜尋引擎,以及網站目錄),並提供一些有助你作出選擇的問題。
甚麼是搜尋引擎?
搜尋引擎是一種軟件,可找出與你的搜尋查詢相符的內容,並以搜尋結果的形式返回。
Google 或 Bing 等互聯網搜尋引擎會搜尋萬維網,其他搜尋引擎則在特定的內容集合中搜尋,例如求職網站或研究論文資料庫。
視乎類型而定,搜尋結果可以是一列經排序的網頁連結,也可以是根據所找到的來源撰寫的答案。
搜尋引擎與網頁瀏覽器的分別
網頁瀏覽器是用來開啟和顯示網頁的應用程式,例如 Perplexity 的 Comet、Chrome、Safari、Edge 或 Firefox;而搜尋引擎則是為你找出這些網頁的服務。
當你在瀏覽器的網址列輸入網址,瀏覽器就會帶你前往該網頁。如果你輸入的是搜尋字詞,瀏覽器就會把它傳送到預設搜尋引擎(Comet 是 Perplexity、Chrome 是 Google Search、Edge 是 Bing),除非你在瀏覽器設定中更改了預設搜尋引擎
三種主要搜尋引擎
各種搜尋引擎的分別,在於結果的來源和呈現方式。結果可能來自搜尋引擎本身的索引、經授權使用的其他搜尋引擎索引,或同時來自多個搜尋引擎;呈現方式則可以是一列經排序的網頁,或附有引用來源的書面答案。
爬蟲式搜尋引擎和元搜尋引擎都會返回一列經排序的連結,但取得結果的方式不同:爬蟲式搜尋引擎會搜尋自行建立的索引,而元搜尋引擎則會把你的查詢傳送到多個其他搜尋引擎,再整合它們返回的結果。
AI 答案引擎同樣會搜尋索引,但它們不會像傳統搜尋引擎般列出網頁,而是撰寫答案。現時許多搜尋引擎兩者兼備。Google、Bing 和 Brave Search 都會在排序連結上方加入由 AI 撰寫的答案。
類型 | 結果來源 | 你得到的結果 | 最適合 | 取捨 | 例子 |
爬蟲式 | 自有索引,或向爬蟲式搜尋引擎取得授權的索引 | 排序列表(許多會加入 AI 答案) | 廣泛搜尋、尋找特定網頁 | 只反映單一搜尋引擎眼中的網絡;你需要自行比較網頁 | Google、Bing、Brave Search、DuckDuckGo |
元搜尋 | 同時使用多個搜尋引擎 | 排序列表 | 更廣泛的結果 | 較慢:需等待多個搜尋引擎回應,直至達到時限 | eTools.ch、SearXNG、MetaGer |
AI 答案引擎 | 自有索引或經授權的索引 | 附有引用來源的書面答案 | 需要參考多個來源的複雜問題 | 需自行查核引用的網頁 | Perplexity、Google AI Mode |
爬蟲式搜尋引擎
爬蟲式搜尋引擎(例如 Google 或 Bing)會在自己索引中的網頁裡,找出與你的查詢相符的答案。它最適合用於廣泛的網絡搜尋,或尋找特定網站或網頁。
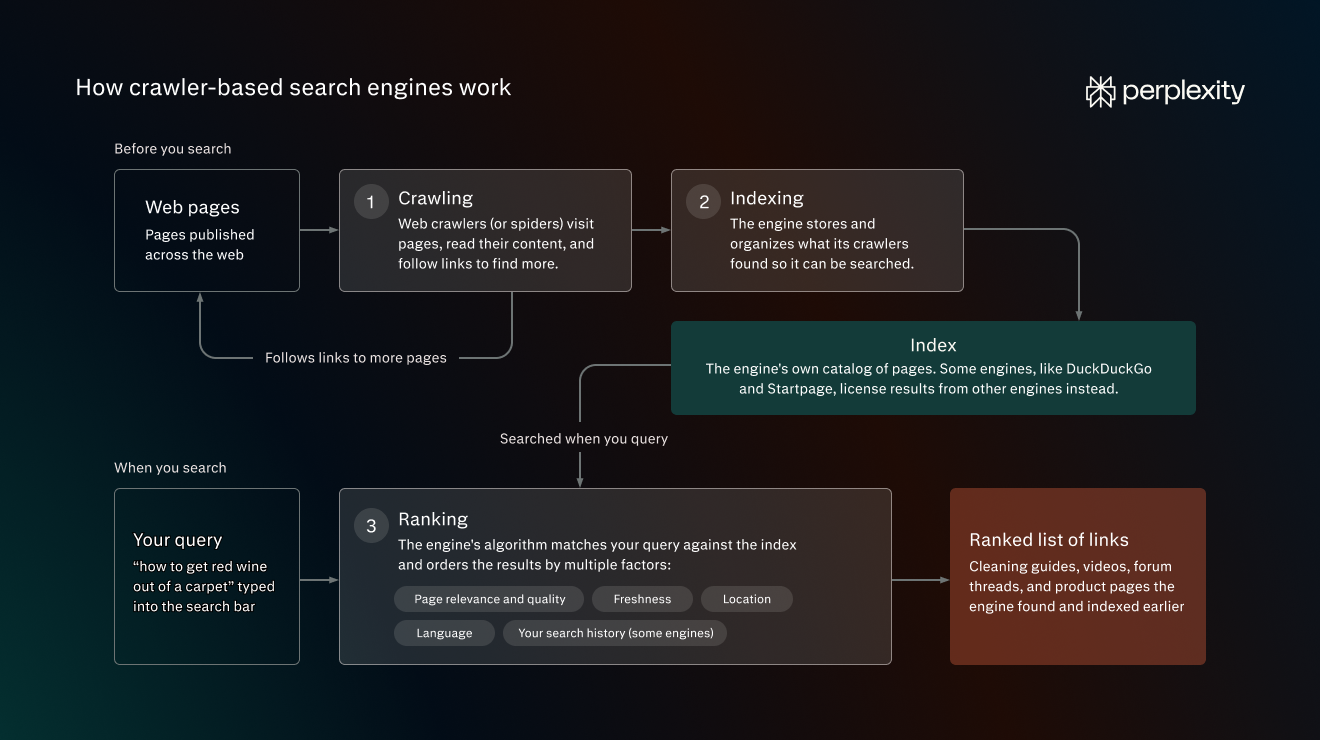
爬蟲式搜尋引擎的運作方式如下:
- 爬取:名為網絡爬蟲(或稱蜘蛛)的程式會瀏覽網頁、讀取內容,並跟隨連結找出更多網頁。
- 建立索引:搜尋引擎會儲存並整理爬蟲找到的內容,以便進行搜尋。
- 排序:當你進行搜尋時,搜尋引擎的演算法會將你的查詢與索引比對,並按多項因素為結果排序,例如網頁的相關性和質素、時效性、地點、語言,部分搜尋引擎還會考慮你的搜尋紀錄。
因此,當你在搜尋列輸入「如何清除地氈上的紅酒漬」,搜尋結果頁面就會顯示一列經排序的清潔指南、影片、討論區帖子和產品頁面,這些都是搜尋引擎先前已發現並編入索引的內容。
為了在爬蟲式搜尋引擎中取得排名,搜尋引擎優化(SEO)專家會確保每個重要網頁都容易被爬取和編入索引,並能比競爭網頁更好地回應關鍵字背後的查詢。
Google Search 佔據最大的搜尋市場份額,是最著名的爬蟲式搜尋引擎。其他例子包括 Bing、Brave Search,以及英國的 Mojeek 和瑞典的 Marginalia 等獨立搜尋引擎。
有些搜尋引擎不會自行爬取網絡,而是向其他搜尋引擎取得結果授權。例如,DuckDuckGo 的傳統連結主要來自 Bing(另加其自家爬蟲),而 Startpage 的結果則來自 Google 和 Bing。
元搜尋引擎
元搜尋引擎會把你的查詢傳送到多個其他搜尋引擎,並整合它們的結果。例如,eTools.ch 會搜尋 17 個不同的資料來源。
元搜尋引擎會分四個步驟回應搜尋查詢:
- 將查詢同時發送到多個搜尋引擎。
- 從每個搜尋引擎收集結果。
- 合併重複結果並重新評分。例如,如果多個搜尋引擎都將某個網頁排在前列,該網頁的排名就會上升。
- 在單一頁面顯示經排序的結果。
當你在 eTools.ch 搜尋「如何清除地氈上的紅酒漬」,就會收到來自 DuckDuckGo、Yahoo、Google 等搜尋引擎的結果。在我們的測試中,Google 排名第 1 的結果在這裡只排第 4。
如果你想擴大搜尋範圍,元搜尋引擎是不錯的選擇,但由於它們需要等待多個搜尋引擎回應(直至達到時限),載入速度可能較慢。
除了 eTools.ch,熱門的元搜尋引擎還包括 SearXNG、MetaGer 和 Dogpile。
DuckDuckGo 有時會出現在元搜尋引擎列表中,但它的結果其實是向 Bing 取得授權,而非整合多個搜尋引擎的結果。
AI 答案引擎
AI 搜尋引擎(例如 Perplexity)會搜尋來源,並利用這些來源為你的具體問題撰寫答案,同時附上連結至所用網頁的引用來源。
AI 答案引擎的運作方式:
- 理解問題:大型語言模型(LLM)會解讀你的查詢(包括冗長的對話式問題),並可能將其拆分為多個搜尋,這個過程稱為查詢擴展(query fan-out)。
- 搜尋來源:它會在網絡索引中執行這些搜尋,讓答案能夠參考模型訓練完成後才發佈的網頁;它亦會針對問題為個別段落評分,而不只是為整個網頁評分。
- 撰寫答案:LLM 會根據檢索到的段落撰寫答案。
與爬蟲式搜尋引擎一樣,AI 答案引擎也會搜尋索引,可以是自有索引或經授權的索引。例如,Perplexity 使用自家索引,而 ChatGPT Search 則結合自家索引與第三方索引。
AI 答案引擎會彙整多個來源的資訊來編寫答案,因此最適合處理單一網頁難以解答的複雜或具體查詢。
例如,當我們問 Perplexity:「我 16 歲的女兒在伊利諾州持有學習駕駛執照,但我們 3 月要搬到亞利桑那州。她現在應該繼續記錄練習時數嗎?亞利桑那州會承認這些時數嗎?她需要帶甚麼到亞利桑那州 MVD?」它使用了 15 個來源來回答問題的每個部分。
在 Google 的傳統排序結果中(不含 AI Overview),同一問題會返回一列網頁,你需要逐一開啟並自行尋找相關資訊。
不過,LLM 在撰寫答案時可能會產生幻覺,因此在依賴 AI 答案之前,請開啟引用的網頁並查證答案中的說法。
要在 AI 答案中獲得引用,網頁需要同樣的 SEO 基礎。不過,答案引擎優化(AEO)更著重於讓內容易於被 AI 答案引擎處理和引用,例如讓每個段落都清楚回答一個具體問題,即使脫離上下文也能看得明白。
其他類型的搜尋引擎
搜尋引擎亦可按用途、對象或商業模式分類。其中部分類別與三種主要類型有所重疊。例如,注重私隱的搜尋引擎可以使用自有索引,也可以取得結果授權。
類型 | 與別不同之處 | 最適合 | 取捨 | 例子 |
注重私隱 | 不追蹤個人資料 | 不希望與你的搜尋紀錄掛鈎的搜尋 | 沒有個人化結果 | DuckDuckGo、Startpage |
付費、無廣告 | 靠訂閱而非廣告營運 | 沒有廣告或廣告定向的結果 | 短期免費試用後需訂閱 | Kagi |
垂直 | 只搜尋單一類型的內容 | 專門內容,並提供針對該內容的篩選器 | 不包括該集合以外的任何內容 | PubMed、Indeed、YouTube |
地區 | 針對單一國家或語言調整 | 以該語言搜尋或尋找本地資訊 | 在本土語言及市場以外的覆蓋範圍較弱 | Yandex、Seznam、Baidu、Naver |
網站目錄或混合式 | 由人工編輯挑選的網站,有時會混合經篩選的爬蟲結果 | 針對單一主題或特定受眾、經審核的起點 | 結果少得多,更新緩慢 | Curlie、MedlinePlus、Kiddle、fragFINN |
企業 | 搜尋機構自家的應用程式和檔案 | 尋找內部文件、訊息和紀錄 | 只涵蓋你的機構已連接的來源 | Coveo、Atlassian Rovo、Onyx |
注重私隱的搜尋引擎
注重私隱的搜尋引擎(例如 DuckDuckGo 或 Startpage)不會保留任何可追溯到你的搜尋紀錄。
DuckDuckGo 不會儲存或分享你的搜尋紀錄,而 Startpage 會移除你的 IP 位址,以及其他引擎用來提供個人化結果的個人資料。
兩者的結果均由較大型的引擎授權提供(DuckDuckGo 使用 Bing,Startpage 使用 Google 和 Bing),因此你仍可受惠於大型索引,同時享有更多私隱保障。
付費、無廣告的搜尋引擎
付費搜尋引擎(例如 Kagi)由用戶的訂閱費資助,而非依靠廣告。
付費搜尋引擎無需為投放廣告而收集個人資料,而且可能會以不同方式為網頁排名。
例如,Kagi 會調低充斥廣告和追蹤器的網頁排名,因為它發現這類網頁往往內容質素較低;同時亦會推廣獨立網站和個人網站。
垂直搜尋引擎
垂直搜尋引擎專注於單一類型的內容,例如研究論文、職位或影片。舉例來說,PubMed 搜尋生物醫學文獻,Indeed 搜尋職位空缺,而 YouTube、TikTok 或 Reddit 等用戶生成內容(UGC)平台則只搜尋其自身的內容。
由於每個引擎只涵蓋一種內容,你可以用一般引擎做不到的方式篩選搜尋結果,例如按薪酬範圍或出版類型篩選。
地區搜尋引擎
地區搜尋引擎(例如俄羅斯的 Yandex、捷克的 Seznam 或中國的 Baidu)專注於單一國家或語言。當你以該語言搜尋或進行本地搜尋(例如尋找附近的商店或服務)時,它們可提供更相關的結果。
部分地區搜尋引擎在其本土市場佔有大量份額。例如,Yandex 佔俄羅斯搜尋引薦流量的 70.22%,而 Google 則佔 28.36%(StatCounter,2026 年 10 月)。
網站目錄與混合式搜尋引擎
網站目錄會列出由人工編輯挑選並按主題分類的網站。
例如,由義工營運、作為 DMOZ 繼任者的 Curlie,收錄了超過 300 萬個由義工編輯加入的網站;而由美國國家醫學圖書館營運的 MedlinePlus,則就每個健康主題收集經審核的網頁。
混合式引擎將網站目錄列表與爬蟲結果結合。兒童搜尋引擎 Kiddle 會將經編輯審核的網頁置於搜尋結果頂部,其後是經 Google SafeSearch 篩選的結果;而 fragFINN 只會傳回由媒體教育工作者團隊列入白名單的網頁。
企業搜尋引擎
企業搜尋引擎(例如 Coveo、Atlassian Rovo 或 Onyx)會搜尋機構自身的內容,例如文件、電郵、資料庫項目和聊天訊息,這些都是公共搜尋引擎無法觸及的內容。
企業搜尋引擎會將機構應用程式(例如 Slack、Gmail、Notion 或 Salesforce)中的內容和中繼資料同步至私人索引,或即時查詢這些應用程式,然後根據每位用戶的存取權限篩選結果,讓用戶只會看到其獲授權查看的內容。
如何選擇最佳搜尋引擎
選擇最切合你需要的搜尋引擎時,請考慮以下因素:
- 相關性:Google 和 Bing 涵蓋多種語言,但地區引擎在其本土語言中可能會提供更相關的搜尋結果。至於專業內容,PubMed 等垂直引擎會為內容建立索引,並提供一般引擎沒有的篩選器。
- 答案格式:處理複雜的查詢,或可供排名的內容不多時,AI 答案引擎會較快捷。不過,它可能會出錯,因此切勿未經核實就將答案用於高風險的決策。
- 速度:以爬蟲為基礎的引擎會即時載入結果,而元搜尋引擎只是稍慢一點。AI 答案引擎需要較長時間撰寫答案,但當找出答案需要閱讀多個來源時,就能節省時間。
- 私隱:部分引擎會部分根據你的搜尋紀錄和其他個人資料為結果排名。如果你不想分享這些資料,或不想讓搜尋紀錄影響結果,請使用 DuckDuckGo 和 Startpage 等私密搜尋引擎。
- 廣告:如果你不想看到廣告,請使用 Kagi 等付費引擎。
- 搜尋體驗:查看有哪些篩選器,以及結果是否易於瀏覽。Google 和 Bing 亦讓用戶以圖片搜尋,因此你可以找到包含特定圖像的網頁。DuckDuckGo、Brave Search 和 Kagi 支援 bangs,這種快捷指令可將搜尋直接傳送至另一個網站的結果。
Perplexity:擁有自家搜尋索引的 AI 答案引擎
Perplexity 是一款 AI 答案引擎,會搜尋其索引和即時網絡,為你的問題撰寫答案,並附上連結至來源的編號引用,讓你可以查證每項說法的出處。
Perplexity 的爬蟲 PerplexityBot 會為其索引收集網頁。當你提出問題時,Perplexity 會挑選最能回答問題的段落,並據此撰寫答案。Perplexity 亦可在回答時即時開啟網頁。
對於需要更深入答案的問題,研究模式會執行數十次搜尋、閱讀數以百計的來源,並將研究結果整合成一份完整報告,你可以將報告匯出為 PDF 或文件。
常見問題
最常用的搜尋引擎有哪些?
根據 StatCounter 的數據,按 2026 年 10 月的搜尋引薦流量份額計算,Google 以 91.05% 居首,其次是 Bing(4.8%)、Yahoo(1.18%)、Yandex(1.14%)和 DuckDuckGo(0.64%)。
除了 Google,還有哪些熱門的搜尋引擎?
除了 Google 之外,Perplexity 是熱門的 AI 答案引擎,而 Bing、DuckDuckGo、Yandex、Baidu 和 Brave Search 則是會傳回網頁排名列表的熱門搜尋引擎。其中部分引擎亦會加入 AI 撰寫的答案。
最早的搜尋引擎有哪些?
第一個互聯網搜尋引擎是 Archie,由 Alan Emtage 於 1989 年開發。其後在 1990 年代中期,出現了 WebCrawler 等以爬蟲為基礎的網絡搜尋引擎。Dogpile 於 1996 年推出,是最早的元搜尋引擎之一,而 Google 則於 1998 年註冊成立。
搜尋引擎有多少種不同類型?
按結果的來源和你得到的內容劃分,搜尋引擎主要有三種類型:以爬蟲為基礎的引擎、元搜尋引擎和 AI 答案引擎。一個引擎可以同時屬於多於一個類別,因為現時許多以爬蟲為基礎的引擎都會加入 AI 答案。
若按用途、受眾或商業模式劃分,類型就更多,包括注重私隱、付費、垂直、地區和企業引擎,以及網站目錄。
視覺搜尋和語音搜尋算是搜尋引擎的類型嗎?
視覺搜尋和語音搜尋並非搜尋引擎的類型,而是搜尋的方式。視覺搜尋(例如 Google Lens)以圖片而非文字作為起點,而語音搜尋(在手機或智能家居裝置上使用)則以語音作為起點,但它們通常會搜尋與文字輸入搜尋相同的索引。
搜尋引擎和答案引擎有甚麼分別?
傳統搜尋引擎會傳回與你的查詢相符的網頁排名列表。答案引擎則會閱讀網頁並撰寫一個答案,並附上連結至其來源的引用。
部分搜尋引擎現已兩者兼備。例如,Google 有 AI Mode 和 AI Overviews,Bing 亦然。