
AI 記憶:是什麼、如何運作,以及會儲存哪些內容
AI 記憶指南:AI 助理如何儲存並回想過去對話中的細節、會儲存哪些內容、記憶可能在哪些地方出錯,以及如何檢視、編輯或關閉它。
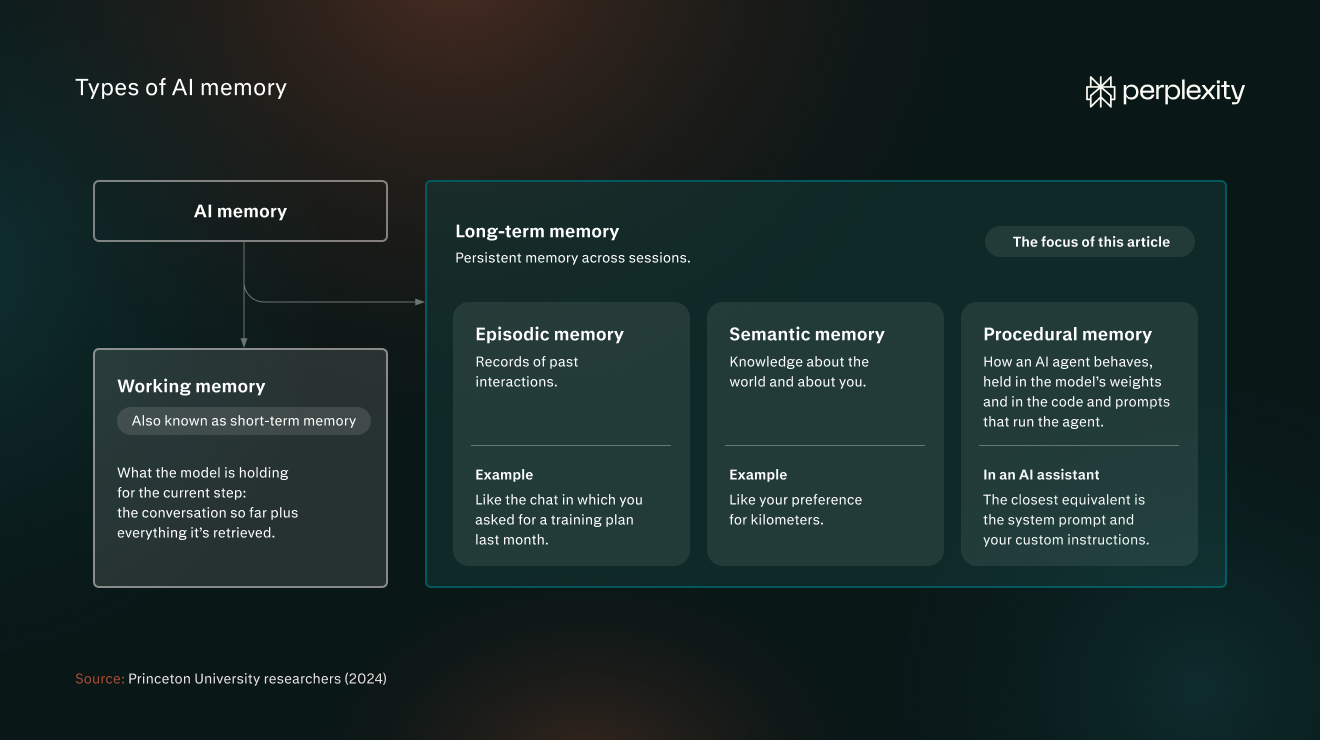
AI 記憶是對話式 AI 助理從你過去的對話中儲存下來、並帶入新對話的資訊,讓它能記住你的偏好與脈絡。模型本身不會保留任何這些資訊。助理會另外儲存這些資訊,並在相關時重新加入,為模型提供原本缺乏的持續性脈絡。
本指南說明助理如何儲存與回想這些資訊、會儲存哪些內容、為何有時會出錯,以及如何查看、變更或關閉這項功能。
什麼是 AI 記憶?
AI 記憶又稱持久記憶,是指 AI 助理的一項功能,可儲存與你有關的資訊,例如偏好、事實,以及過去互動中的脈絡,讓助理能在之後的對話中使用。
AI 助理建立這份紀錄的來源包括:你要求它記住的事項、它自行留意到的細節,以及它可以回頭參考的先前聊天。
AI 記憶層讓 AI 助理不需要你在每次聊天中重述偏好,就能提供個人化的回答。如果你曾告訴助理你正在為馬拉松進行訓練,而且偏好使用公里,那麼下次詢問配速問題時,即使你沒有重新說明,也會得到以公里為單位的回答。
相較於在每次聊天中重述自己的情況,記憶能省去打字的工夫,並讓提示保持簡短;這點很重要,因為過長的輸入會降低回答的準確度。
記憶並不是每段對話的逐字紀錄,而是一組與你有關的關鍵事實。因此它會記得你偏好使用公里。至於能否找到它上個月擬定的那份完整訓練計畫,則取決於助理是否也能查詢過去的聊天。
AI 記憶的類型
普林斯頓大學的研究人員(2024 年)借用人類記憶科學的術語,將 AI 記憶系統分為不同類型。他們的架構將工作記憶與長期記憶區分開來:
- 工作記憶:模型在目前步驟中所保留的內容,也就是到目前為止的對話,加上它所擷取的所有內容。又稱為短期記憶。
- 長期記憶:跨工作階段的持久記憶。這也是本文所探討的記憶類型。
長期記憶包含三種記憶類型:
- 情節記憶:過去互動的紀錄,例如你上個月要求擬定訓練計畫的那段聊天。
- 語意記憶:關於世界以及關於你的知識,例如偏好使用公里。
- 程序記憶:AI 代理程式的行為方式,內建於模型權重,以及驅動代理程式的程式碼與提示中。在 AI 助理中,最接近的對應是系統提示與你的自訂指示。
AI 助理記憶與 AI 代理程式記憶的比較
AI 助理記憶與 AI 代理程式記憶都屬於長期記憶。AI 助理記憶大多是語意記憶,會儲存關於你的事實,讓回答更符合你的需求。代理程式記憶(例如 Perplexity 的 Brain)則會儲存代理程式做過的事及其結果,包括哪些做法有效、哪些經你修正過,讓它在每項新任務開始時都處於更有利的位置。
AI 助理記憶 | AI 代理程式記憶 | |
記住的內容 | 你 | 任務及其歷程 |
用途 | 符合你需求的回答 | 接續多步驟工作,不必從頭開始 |
範例 | 記得你偏好使用公里 | 記得你的馬拉松訓練計畫、它所做的調整,以及你目前已完成的訓練課程,以便更妥善地規劃後續的訓練階段 |
AI 記憶與上下文視窗、訓練資料及自訂指示的比較
AI 記憶很容易與另外三種影響回答的因素混淆:模型的上下文視窗、訓練資料與自訂指示。這幾者各自保存不同的資訊、持續時間長短不一,並由不同的系統控制。
上下文視窗是大型語言模型(LLM)一次能讀取的文字量,涵蓋目前的對話。當你開始新的聊天時,它就會重設。
目前有些模型擁有一百萬個 token 以上的大型上下文視窗,因此技術上你可以把關鍵資訊貼到每段對話中。但處理這麼多內容會增加延遲與成本。
多項研究也發現,即使答案就在上下文中,輸出的準確度仍會隨著輸入增加而下降。
一項 2025 年的伊利諾大學與 Amazon 研究發現,即使模型能複述每個相關細節,這種情況仍會發生:當輸入增加到 30,000 個 token 時,準確度下降了 13.9% 至 85%,遠低於模型宣稱的上限。Adobe Research 與慕尼黑大學(LMU Munich)於 2025 年推出的基準測試 NoLiMa 發現,只要問題與答案沒有共同的關鍵字,13 個受測模型中就有 11 個在僅 32,000 個 token 時表現便大幅下滑。Chroma 2025 年 7 月的報告在 18 個模型中都觀察到這種現象,包括模型根據 113,000 個 token 的聊天紀錄作答時。
訓練資料是模型發布前就內建於其權重中的資訊。使用者無法變更這些資訊。開發人員可以用新資料微調模型,但那是一項工程流程,而不是使用者設定。
自訂指示是儲存在助理設定中的規則,由你親自撰寫與編輯,用來自訂 AI 助理的行為與輸出內容。例如,你可以透過自訂指示設定回答的語氣與風格,或是助理可使用哪些來源。
以下是這四者的比較:
上下文視窗 | AI 記憶 | 訓練資料 | 自訂指示 | |
保存的內容 | 目前聊天中的訊息 | 已儲存、與你有關的事實和偏好 | 模型在發布前學到的內容 | 你親自撰寫的指引 |
持續時間 | 僅限此次聊天 | 直到被更新或刪除為止 | 固定不變,直到新模型發布為止 | 直到你編輯為止 |
控制者 | 你,但須在模型供應商設定的限制內。 | 你與助理 | AI 公司 | 你 |
範例 | 你一分鐘前問的配速問題 | 你偏好使用公里 | 馬拉松訓練計畫一般的架構方式 | 將訓練計畫以表格呈現的指示,其中列代表週次、欄代表星期幾 |
AI 記憶會儲存什麼
助理會保留與你有關的特定細節,例如事實、偏好和摘要,有些助理也會參考你過去的聊天。
- 你要求它記住的事實與偏好:這些是你明確告訴助理要儲存的細節,例如「記住我偏好使用公里」。助理會在你提出要求時建立這則記憶,並保留到你將其刪除,或之後的對話更新它為止。
- 它從你的對話中留意到的細節:當這項設定開啟時,助理會儲存這些細節。Perplexity「會優先考量使用者提問的頻率和提供的資訊」,因此你經常提到的事,比只提過一次的事更可能被記住。這則記憶會保留到被更新或你將其刪除為止。
- 參考你過去的聊天:助理會直接參考先前的對話,而非已儲存的清單。Perplexity 將此稱為搜尋紀錄:也就是你過去的提問與回答,用來讓新的回應更切合需求。
AI 記憶的運作方式
AI 模型在不同對話之間不會記住任何事。這項工作是由 AI 記憶系統負責:它會另外保存一份關於你的紀錄,並將相關部分加入每段新對話中。儲存與擷取都在背景進行,因此模型會將這些內容與你的問題一併讀取。
這個流程分為五個步驟:
- 儲存:當你提出要求,或助理判斷某個細節值得保留時,就會儲存一則記憶。
- 存放:記憶會存入與模型分開保存的資料庫。在許多系統中,這是一個向量資料庫,因此可以依照語意搜尋記憶。你在設定中看到的清單,就是這個記憶庫的檢視畫面。
- 擷取:當你傳送訊息時,助理會決定要套用哪些記憶。許多系統的做法是將你的訊息和每則記憶轉換成嵌入向量(以數值表示的語意),再挑選最相近的結果。因此,即使某則記憶與你的問題沒有任何共同字詞,系統仍能回想起它。較簡單的系統則會將所有已儲存的記憶載入每段對話。
- 使用:回想起的記憶會以純文字形式插入輸入內容,通常位於模型在讀取你的訊息前會先讀取的指示區塊中。模型會像處理該輸入中的其他文字一樣處理這些記憶。
- 更新與移除:助理會從聊天中萃取事實、搜尋現有記憶,並決定要將其新增為新記憶、更新現有記憶、與某則記憶合併,或刪除與新發現相矛盾的舊記憶。有些助理會為每則記憶加上時間戳記,以區分新舊資訊。
AI 記憶的挑戰與風險
AI 記憶的目的是提升回答品質,但基準測試顯示,記憶擷取不一定能找出相關或最新的資訊,尤其是從大型資料庫中擷取時。它也會帶來安全性與隱私權風險。
與 AI 記憶相關的常見可靠性與安全性問題包括:
- 記憶誤用:記憶可能被帶入毫不相干的回答中。一項 2026 年的研究測試了 18 個模型,檢驗某個生活領域中儲存的記憶是否會滲入另一個領域的回答。失敗率中位數為 53%。該研究也發現,一旦記憶中保存了使用者的信念或其自稱的專業知識,即使問題需要中立的回答,幾乎每個模型都會附和這些內容。
- 過時的記憶:在之後的對話已讓某個細節不再屬實後,助理仍繼續依據該細節行事,尤其是當你從未明確說明時。在一項測試模型能否察覺這類隱含變化的 2026 年 5 月基準測試中,表現最好的模型平均分數為 55.2%。
- 記憶過載:助理需要回頭讀取的內容越多,就越難挑出重點。2024 年的基準測試 LongMemEval 發現,讀取約 115,000 個 token 聊天紀錄的模型,表現比只獲提供相關工作階段的模型差了 30% 至 60%。
- 記憶投毒:錯誤資訊或隱藏指示進入助理的記憶中(例如透過你要求它讀取的內容),導致回答出現偏誤或不安全,甚至造成資料外洩。
- 隱私權風險:記憶會在原本的聊天之外保留個人細節,有時保留的時間比你預期得更久。例如,Perplexity 可能會基於安全與除錯目的,將已刪除記憶的紀錄保留最多 30 天。資料保護法將儲存的記憶視為個人資料,因此你應能檢閱並刪除這些記憶。
如何查看、編輯及關閉 AI 記憶
你可以查看助理已儲存的內容、將其刪除、關閉記憶功能,或使用不會建立記憶的私人聊天。
記憶管理歸根究柢就是幾項控制選項。以下說明各項的功能與使用時機:
控制選項 | 功能 | 使用時機 |
查看已儲存的內容 | 開啟你的記憶庫,你可以在其中搜尋、篩選及檢閱個別項目。 | 當回答中出現你意料之外的細節時。 |
刪除記憶 | 移除該項目,助理之後的回答便不會再使用它(助理可能會在一段時間內保留已清除記憶的紀錄)。 | 當某則記憶有誤、過時或涉及敏感資訊時。 |
關閉記憶 | 讓助理在之後的回答中不再參考記憶(這可能不會清除已儲存的記憶,請查看你所用助理的說明)。 | 當你想要不經個人化的回答時 |
關閉搜尋紀錄 | 讓助理不再使用你過去的提問與回答。從搜尋紀錄中刪除某個工作階段,即可消除它對之後回答的影響。 | 當過去的對話左右了答案時,您會想重新開始。 |
使用無痕聊天 | 記憶與搜尋記錄一律關閉,在其中提出的問題絕不會被保留,也不會用於記憶。 | 適用於一次性或敏感的話題。 |
若想完全從頭開始,請關閉記憶並清除已儲存的內容。
Perplexity 如何處理記憶
Perplexity 記憶適用於其提供的所有模型。
Perplexity 會根據兩種來源將答案個人化:記憶(也就是您分享的偏好與細節),以及您的搜尋記錄。當某則記憶影響了答案時,它會出現在該答案的來源中,讓您能看到使用了哪些記憶,並刪除其中任何一則。
您也可以提供關於自己的詳細資訊,並為專案提供自訂指示,藉此將答案個人化(每個專案都有自己的記憶層)。
Perplexity 可能會將消費者帳戶的記憶內容用於改進其模型(Enterprise 帳戶則絕不會),除非您關閉此功能(位於「設定 → 偏好設定 → 人工智慧」中的「AI 資料保留」)。
Max 與 Enterprise Max 訂閱者還能使用 Brain,這是一個共享記憶層,以記憶為基礎,進一步追蹤您的專案與工作。它有獨立的切換開關,且會忽略無痕工作階段。
試用 Perplexity,看看記憶如何影響您的下一個答案。
AI 記憶常見問題
AI 中的有限記憶是什麼?
根據 IBM 的定義,有限記憶 AI 是指能夠回想過去的事件與結果,並隨時間監控情況,但無法將這些資料保存在由過往經驗構成之長期資料庫中的 AI。這是 AI 系統分類法中的四個類別之一,IBM 將聊天機器人與虛擬助理歸入此類。
助理記憶則是這些系統額外附加的外部記憶。它會跨工作階段保留,因此助理能使用您在先前對話中分享過的細節。
哪個 AI 助理的記憶最好?
沒有任何一款助理適合所有人。好的記憶是您能掌控的記憶,因此評估 AI 工具時,可以問四個問題:您能看到它儲存了什麼嗎?您能將某則記憶與其來源聊天分開刪除嗎?訓練是否為獨立於記憶的設定?是否有不會建立任何記憶的臨時或無痕模式?
AI 模型會從它記得的關於您的資訊中學習嗎?
在答案中使用記憶,與訓練是不同的過程。Perplexity 表示,它會從您的記憶儲存區擷取相關脈絡,而不是將您的記錄當作訓練資料。您的內容能否用於改進模型,則是另一項獨立設定。在消費者帳戶上,Perplexity 可能會將記憶內容用於此目的,而「AI 資料保留」可將其關閉。
哪些內容不應放入 AI 記憶?
任何您不希望被儲存、被用來建立您的個人剖析或日後被重複提及的內容,都不應放入 AI 記憶:身分與財務資料、健康資訊、密碼、他人的資訊,以及任何與兒童有關的內容。加拿大隱私專員辦公室(2025 年 5 月)與英國國家網路安全中心(2023 年 3 月)都建議,若某個提示詞一旦公開就會造成問題,就不要輸入。
篩選機制能降低隱私風險,但無法保證您的健康或財務資訊完全不會被儲存,因此請檢查您的記憶庫,並在詢問一次性的敏感問題時使用無痕模式。