
Truljenje konteksta kod AI agenata: zašto dugi zadaci gube tačnost i kako to sprečiti
Vodič o tome šta se nagomilava u kontekstu AI agenta, zašto to narušava tačnost i kako podesiti zadatke koji ostaju pouzdani.
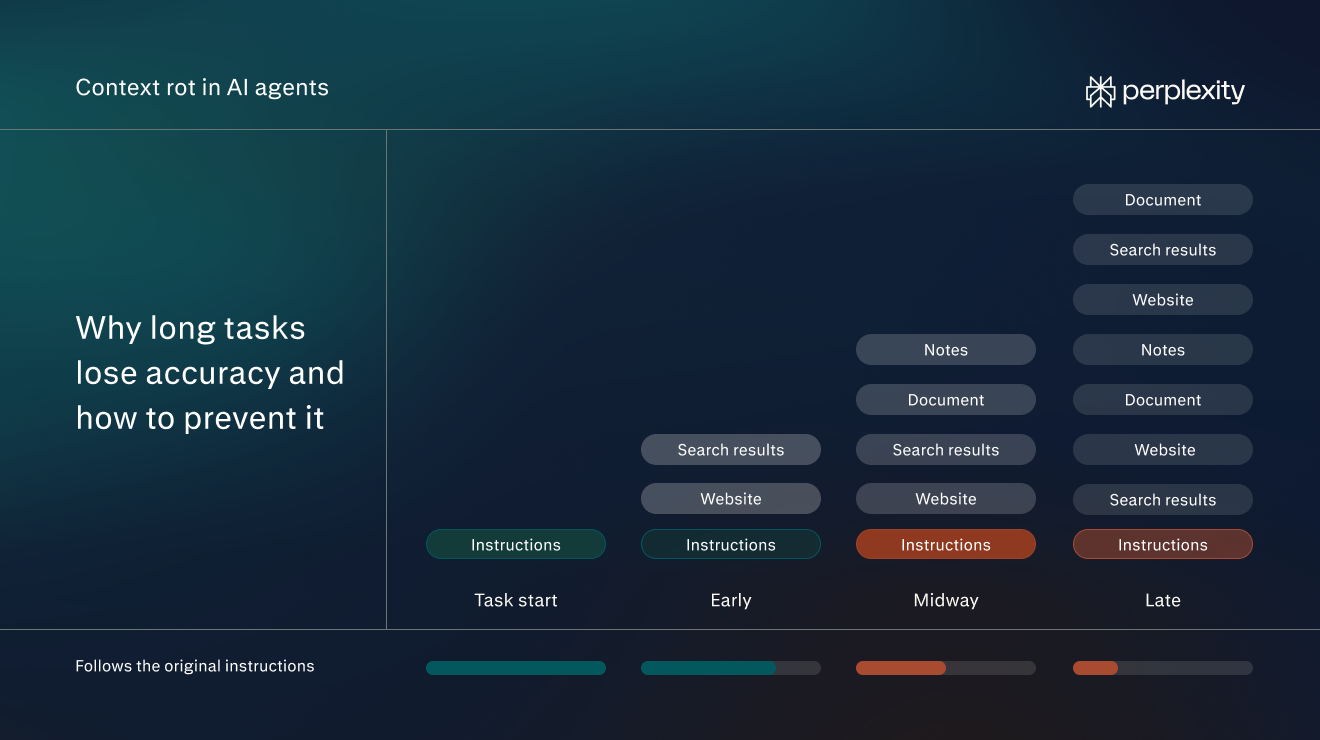
Šta truljenje konteksta znači za AI agente
Truljenje konteksta kod AI agenata je postepeni gubitak tačnosti do kog dolazi kako se kontekst agenta popunjava tokom dugog zadatka.
Kontekst agenta čine informacije koje su modelu dostupne za sledeći korak. One mogu da obuhvate uputstva, ranije poruke, rezultate pretrage i tekst sa veb-sajtova ili iz datoteka. Dok agent radi, može da dodaje još informacija.
Na primer, recimo da je zadatak agenta da pronađe dobavljače koji isporučuju u roku od dve nedelje. Na početku njegov kontekst sadrži samo taj zahtev. Na polovini zadatka kontekst će sadržati i tekst desetina veb-sajtova dobavljača, nekoliko stranica rezultata pretrage i beleške o tome koje je dobavljače agent već proverio.
Postoji ograničenje koliko konteksta model može da primi (to se naziva kontekstni prozor). Prozor se meri u tokenima, koji su mali delovi teksta, obično reč ili deo reči. Truljenje konteksta se pojačava kako kontekst raste, zbog čega se najčešće javlja u dugim zadacima sa mnogo koraka.
Kako truljenje konteksta napreduje, agent postaje manje tačan. Može manje dosledno da prati prvobitna uputstva, da previdi detalje ili da informacije koje samo izgledaju slično zameni za one koje su mu potrebne.
Na primer, agent bi mogao da počne da uključuje dobavljače kojima treba šest nedelja, iako mu je rečeno da traži isporuku u roku od dve nedelje. Uputstvo je i dalje u njegovom kontekstu, ali više ne usmerava izbore agenta.
Truljenje konteksta nije isto što i puko ponestajanje prostora u kontekstnom prozoru. Kada kontekst zadatka preraste prozor, deo materijala se odseca ili zadatak ne uspeva. Truljenje konteksta počinje mnogo pre te tačke, dok još sve staje u prozor.
Nije isto ni što i trovanje konteksta (kada obmanjujuće ili štetne informacije dospeju u kontekst agenta). I agent koji ima tačne i potpune informacije može da iskusi truljenje konteksta.
Zašto dolazi do truljenja konteksta
Do truljenja konteksta dolazi zato što je pažnja modela ograničena, čak i kada u njegovom kontekstnom prozoru ima dovoljno mesta. Kod AI modela, pažnja je tehnički termin za način na koji model odlučuje na koje delove svog ulaza da se osloni dok piše svaku reč odgovora. Svi delovi konteksta se takmiče za tu pažnju. Što je teksta više, to svaki deo dobija manje pažnje.
Na primer, Chroma je objavila studiju o tome kako dužina ulaza utiče na AI modele. Testirano je 18 modela kompanija Anthropic, OpenAI, Google i Alibaba. U jednom testu istraživači su sakrili rečenicu sa savetom o pisanju unutar duge zbirke eseja. Zatim su pitali model koji je to savet.
Test su ponovili mnogo puta, svaki put dodajući još teksta iz eseja. Rečenica i pitanje se nikada nisu menjali. Menjala se samo količina teksta oko njih.
Što su modeli morali da pročitaju više teksta, to su lošije radili. Ovaj nalaz se potvrdio u svakom testu iz izveštaja. Istraživači predviđaju da bi pad tačnosti bio još veći u stvarnom radu koji zahteva mnogo koraka, kao što je slučaj sa većinom zadataka agenata.
Kako truljenje konteksta može da utiče na AI agente
Truljenje konteksta se obično ispoljava na jedan od četiri načina:
Gubljenje prvobitnih uputstava iz vida
U najjednostavnijem testu kompanije Chroma modeli su trebalo da tačno prepišu dugačak niz ponovljenih reči u koji je negde umetnuta jedna drugačija reč. Bio je to trivijalan zadatak sa eksplicitnim uputstvom. Ipak, učinak svih modela je opadao kako je tekst postajao duži. Neki modeli su počeli da proizvode reči kojih uopšte nije bilo u ulazu.
U zadatku agenta korisnik obično na početku postavlja konkretna ograničenja, kao što su budžet ili traženi format. Kako kontekst raste, agent bi mogao manje dosledno da ih primenjuje. Uzrok je ukupna dužina konteksta, a ne mesto na kom se uputstvo nalazi.
Propušteni detalji iz sredine zadatka
AI modeli najpouzdanije koriste informacije koje se nalaze na samom početku ili na samom kraju njihovog ulaza, pokazuje studija sa Stanforda iz 2023. godine. U jednom testu istraživači su modelima dali skup od 20 dokumenata i postavili pitanje na koje je odgovor sadržao samo jedan od njih. Kada je taj dokument bio prvi ili poslednji, modeli su obično pronalazili odgovor. Kada se nalazio u sredini skupa, mnogo češće su ga propuštali. Istraživači ovo nazivaju efektom pozicije.
Isti obrazac važi i za agente. Informacije pronađene ranije u zadatku mogu da se nađu u sredini dugog razgovora, gde neki modeli teže uspevaju da ih iskoriste. U primeru sa dobavljačima, konačna lista bi mogla da izostavi dobrog dobavljača kog je agent proverio negde na polovini zadatka.
Mešanje sličnih informacija
Kako kontekst raste, agentima može biti sve teže da prepoznaju koje informacije odgovaraju njihovim uputstvima. Na primer, recimo da je korisnik rekao agentu da pronađe dobavljače koji šalju robu „u roku od dve nedelje“. Na veb-sajtu jednog dobavljača piše „stiže u roku od 14 kalendarskih dana od porudžbine“. U kratkom zadatku agent bi verovatno uočio da to znači isto. Kada je zatrpan desetinama stranica drugih dobavljača, verovatnije je da će propustiti to podudaranje.
S druge strane, agent bi mogao da počne da uključuje rezultate koji nisu relevantni. Recimo da agent traži dobavljače kancelarijskih stolica. Veb-sajt jednog dobavljača obećava isporuku za dve nedelje, ali samo za stolove. Za njegove stolice treba šest nedelja. Veb-sajt koristi iste reči kao uputstvo, pa agent ipak može da doda tog dobavljača na svoju listu. Istraživači ovakvu informaciju nazivaju distraktorom. Deluje relevantno, ali nije, pa se takmiči sa informacijama koje su zaista važne.
Studija kompanije Chroma pokazala je da su se oba problema pogoršavala kako je rasla količina okolnog teksta.
Greške koje je teško uočiti
Truljenje konteksta ne izaziva poruku o grešci. Agent nastavlja da radi i vraća rezultat koji izgleda završeno. Zbog toga je njegove greške lako prevideti.
U testovima kompanije Chroma ove greške su imale dva oblika. Ponekad je model samouvereno dao pogrešan odgovor. U primeru istraživanja dobavljača, agent bi mogao da isporuči urednu, dobro formatiranu listu dobavljača na kojoj se nalazi dobavljač čije je uslove isporuke pogrešno protumačio.
U drugim slučajevima model je tvrdio da ne može da pronađe informacije koje su zapravo bile tu. Na primer, agent bi mogao da dostavi izveštaj u kom piše da nijedan dobavljač ne ispunjava rok od dve nedelje, iako ga nekoliko njih ispunjava.
Kako podesiti zadatke agenta da biste smanjili truljenje konteksta
Pravilno podešavanje zadataka smanjiće uticaj truljenja konteksta i održati agenta što tačnijim tokom celog zadatka. Sledeće najbolje prakse mogu da pomognu.
Napišite zadatak kao jasno zaduženje
Jasno zaduženje održava kontekst manjim. Agent zna kada je gotov, pa prestaje da prikuplja materijal čim ga ima dovoljno. Konkretni zahtevi mu takođe daju nešto opipljivo sa čim može da uporedi svaku stranicu. Tako agent lakše uočava prave informacije.
Pre slanja zadatka proverite da li obuhvata tri stvari:
- Zadatak: šta agent treba da uradi i proizvede, na primer „pronađi dobavljače i vrati uži izbor“.
- Zahtevi: činjenice koje agent ne može da pogodi, kao što su budžet, rok, adresa isporuke i za koga je rezultat namenjen.
- Rezultat: format, dužina i struktura, na primer „tabela sa nazivom, cenom po stolici i rokom isporuke“.
Kada se sve objedini, upit za zadatak sa dobavljačima mogao bi da izgleda ovako:
„Pronađi 10 dobavljača koji mogu da isporuče 40 kancelarijskih stolica u našu kancelariju u Čikagu u roku od dve nedelje, po ceni manjoj od 250 dolara po stolici. Vrati tabelu sa nazivom dobavljača, cenom po stolici, rokom isporuke i linkom do stranice proizvoda. Lista je za našeg menadžera kancelarije, koji će izvršiti porudžbinu.“
Neka svaki zadatak bude fokusiran
Jedan zadatak sa jednim jasnim ciljem održava kontekst malim. Dugi zadaci su i skuplji. Svaki korak obrađuje sve što je do tada prikupljeno, pa naduvan kontekst troši više kredita u svakom koraku.
Projekat koji ima nekoliko delova podelite:
- Navedite zasebne celine koje treba isporučiti, na primer pretragu dobavljača, poređenje cena i imejl izabranom dobavljaču.
- Pokrenite svaku celinu kao poseban zadatak.
- Iz jednog zadatka u sledeći prenesite samo gotov rezultat. Na primer, otpremite tabelu dobavljača kao datoteku da biste započeli zadatak poređenja, umesto da nastavite u niti u kojoj je nastala.
Zadatak poređenja tada počinje sa jednom tabelom umesto sa svim stranicama.
Uputite agenta na prave izvore
Svaka stranica koju agent pročita dodaje se njegovom kontekstu, uključujući menije, oglase i šablonski tekst oko korisnog dela. Ako agentu direktno date izvore, smanjujete taj šum.
Otpremite datoteke od kojih zadatak zavisi, kao što je lista odobrenih dobavljača, tako što ćete ih priložiti uz upit. Kada agent mora da pretražuje veb, navedite veb-sajtove koje vredi pretražiti, na primer dva pouzdana imenika dobavljača.
Povežite alatke u kojima se informacije nalaze. Na primer, u usluzi Perplexity Computer otvorite Konektore na bočnoj traci i omogućite aplikacije koje su zadatku potrebne, kao što su Google Drive ili Slack. Zatim ih pomenite u upitu: „Koristi specifikacije stolica iz našeg Google Drive-a.“ Povežite samo relevantne aplikacije, jer svaki konektor zauzima deo konteksta agenta.
Ako se informacije nalaze u aplikaciji koja nije na listi konektora, možda je ipak moguće povezati je. Mnoge aplikacije nude MCP (Model Context Protocol) konektor, standardni način na koji se AI alatke povezuju sa drugim softverom. Computer može da ih koristi uz svoje ugrađene konektore. U poslovnom nalogu administrator će ih možda prvo morati da omogući.
Zatražite završnu proveru u odnosu na uputstva
Završite upit korakom provere koji navodi najvažnija ograničenja:
„Pre nego što završiš, proveri svakog dobavljača u odnosu na ove zahteve: isporuka u roku od dve nedelje, cena manja od 250 dolara po stolici. Označi sve koji ne ispunjavaju te zahteve umesto da ih izostaviš.“
Ograničenja se i dalje nalaze na početku konteksta. Korak provere daje agentu razlog da svoj konačni rezultat uporedi sa ograničenjima, umesto da se oslanja na to da će uputstva zadržati uticaj kroz sve korake.
Pored toga, ako od agenta tražite da označi probleme umesto da jednostavno odbaci takve rezultate, greške se lakše uočavaju (na primer, odbacivanje dobavljača koji obećava isporuku u roku od 14 kalendarskih dana samo zato što ne koristi reči „dve nedelje“).
Proveravajte rad na kontrolnim tačkama
Kod dužih zadataka ugradite kontrolnu tačku u upit:
„Počni tako što ćeš pronaći 20 potencijalnih dobavljača, a onda stani. Potvrdiću listu pre nego što prikupiš cene.“
Proverite uži izbor u odnosu na prvobitna uputstva. Ispravite sve što nije u redu u sledećoj poruci, a zatim pustite agenta da nastavi. Greške uočene u ovoj fazi neće se preneti na sve naredne korake.
Započnite novi zadatak kada jedan skrene s puta
Ako agent ponavlja istu grešku i posle ispravki, započnite novi zadatak. Svaka ispravka dodaje još teksta već dugačkom kontekstu. Umesto toga, napravite novi zadatak. Ponovo navedite uputstva, otpremite sav dobar rezultat iz prvog pokušaja i počnite iznova.
Neki agenti automatski rade nešto slično, a taj proces se naziva sažimanje. Kako zadatak postaje dug, agent zamenjuje stariji materijal, kao što je ceo tekst stranica koje je pročitao na početku, kratkim rezimeom onoga što je pronašao. Portable Computer kompanije Perplexity na ovaj način sažima svoj kontekst, tako da model ostaje u okviru količine koju može dobro da obradi.
Važno je i da započnete novi zadatak ako se cilj promeni. Nit koja je počela kao pretraga dobavljača ne bi trebalo da postane i pregled ugovora.
Pretvorite ponovljena uputstva u Skill
Neka uputstva se ponavljaju u svakom zadatku određene vrste, kao što su željeni format tabele, lista dobavljača koje treba izbegavati ili standardni korak provere. U usluzi Computer ona mogu da se sačuvaju kao Skill, skup uputstava za višekratnu upotrebu koji agent prati svaki put. Skill ugrađuje ostale najbolje prakse u svaki zadatak koji ga koristi.
Da biste ga podesili:
- Izaberite zadatak koji se često ponavlja, kao što je istraživanje dobavljača.
- Zapišite uputstva koja dajete svaki put: format, provere, izvore koje treba koristiti ili izbegavati.
- Sačuvajte ih kao Skill. Uputstva koja su već napisana u Markdown formatu mogu se direktno uvesti.
- U budućim upitima navedite Skill po imenu: „Koristi Skill za istraživanje dobavljača da pronađeš dobavljače stolica za kancelariju u Denveru.“
Kako Perplexity pristupa kontekstu u radu agenata
Perplexity Computer obrađuje duge zadatke tako da kontekst svakog modela ostane mali i relevantan. Tri elementa njegovog dizajna ograničavaju koliko model mora da pročita odjednom.
Raspodela posla na podagente
Computer deli zahtev na zadatke i podzadatke, a zatim pravi podagente koji ih izvršavaju. Svaki podagent radi na jednom delu posla u sopstvenom kontekstu. U zadatku sa dobavljačima, jedan podagent bi mogao da istražuje cene dok drugi proverava uslove isporuke. Nijedan ne mora da pročita sve što je pročitao onaj drugi.
Čuvanje rada u datotekama
Svaki Computer zadatak dobija sopstveni radni prostor, sa sopstvenim datotekama, veb-pregledačem i alatkama. Agent može da sačuva svoj rad u datoteku, na primer tabelu dobavljača koje je proverio, koju dopunjuje u hodu. Tu datoteku zatim ponovo otvara samo kada mu zatreba.
Izdvajanje relevantnih odlomaka iz rezultata pretrage
Veb-stranice su pune materijala koji modelu nije potreban, kao što su meniji, oglasi, metapodaci i tekst o drugim temama. Kompresija konteksta prilagođena upitu to uklanja. Pre nego što stranica stigne do modela, Perplexity zadržava samo rečenice koje se odnose na upit.
Istražite savete, vodiče i primere zadataka za Perplexity Computer da biste ove korake primenili u praksi.
Česta pitanja
Da li je truljenje konteksta isto što i halucinacija?
Nije, ali su povezani. Halucinacija je svaki odgovor koji iznosi nešto netačno ili neutemeljeno. Truljenje konteksta je jedan od uslova koji povećavaju verovatnoću halucinacija, kao i drugih grešaka poput zanemarenih uputstava i propuštenih detalja.
Može li bolji upit da reši problem truljenja konteksta?
Jasan upit smanjuje truljenje konteksta tako što zadatak drži fokusiranim. Ipak, ne može da spreči rast konteksta. Kod dovoljno dugog zadatka agent i dalje prikuplja više nego što može dobro da iskoristi, zbog čega su podela posla i usputne provere jednako važne kao i sam upit.
Da li truljenje konteksta utiče i na obične AI četove, a ne samo na agente?
Da. U Chatu je kontekst ceo dosadašnji razgovor, uključujući svaku poruku i sve dokumente koji su u njega nalepljeni ili otpremljeni. Nit koja traje satima i obuhvata nekoliko tema može da dovede do istih grešaka kao dug zadatak agenta. Ako za novu temu započnete novu nit, svaki razgovor ostaje fokusiran.
Koliko dugačak zadatak može da bude pre nego što nastupi truljenje konteksta?
Ne postoji fiksna tačka. Zavisi od modela i zadatka. Na primer, modeli na uređaju sa kontekstnim prozorima od 260.000 tokena počinju da imaju poteškoća iznad otprilike 100.000 tokena, daleko pre svog ograničenja. Pad je takođe postepen, a ne nagao.